Почему ChatGPT всегда включает в заголовки порнографическую и азартную рекламу?
«Нам нужно представить Сизифа… в роли директора индустрии развлечений для взрослых?!»
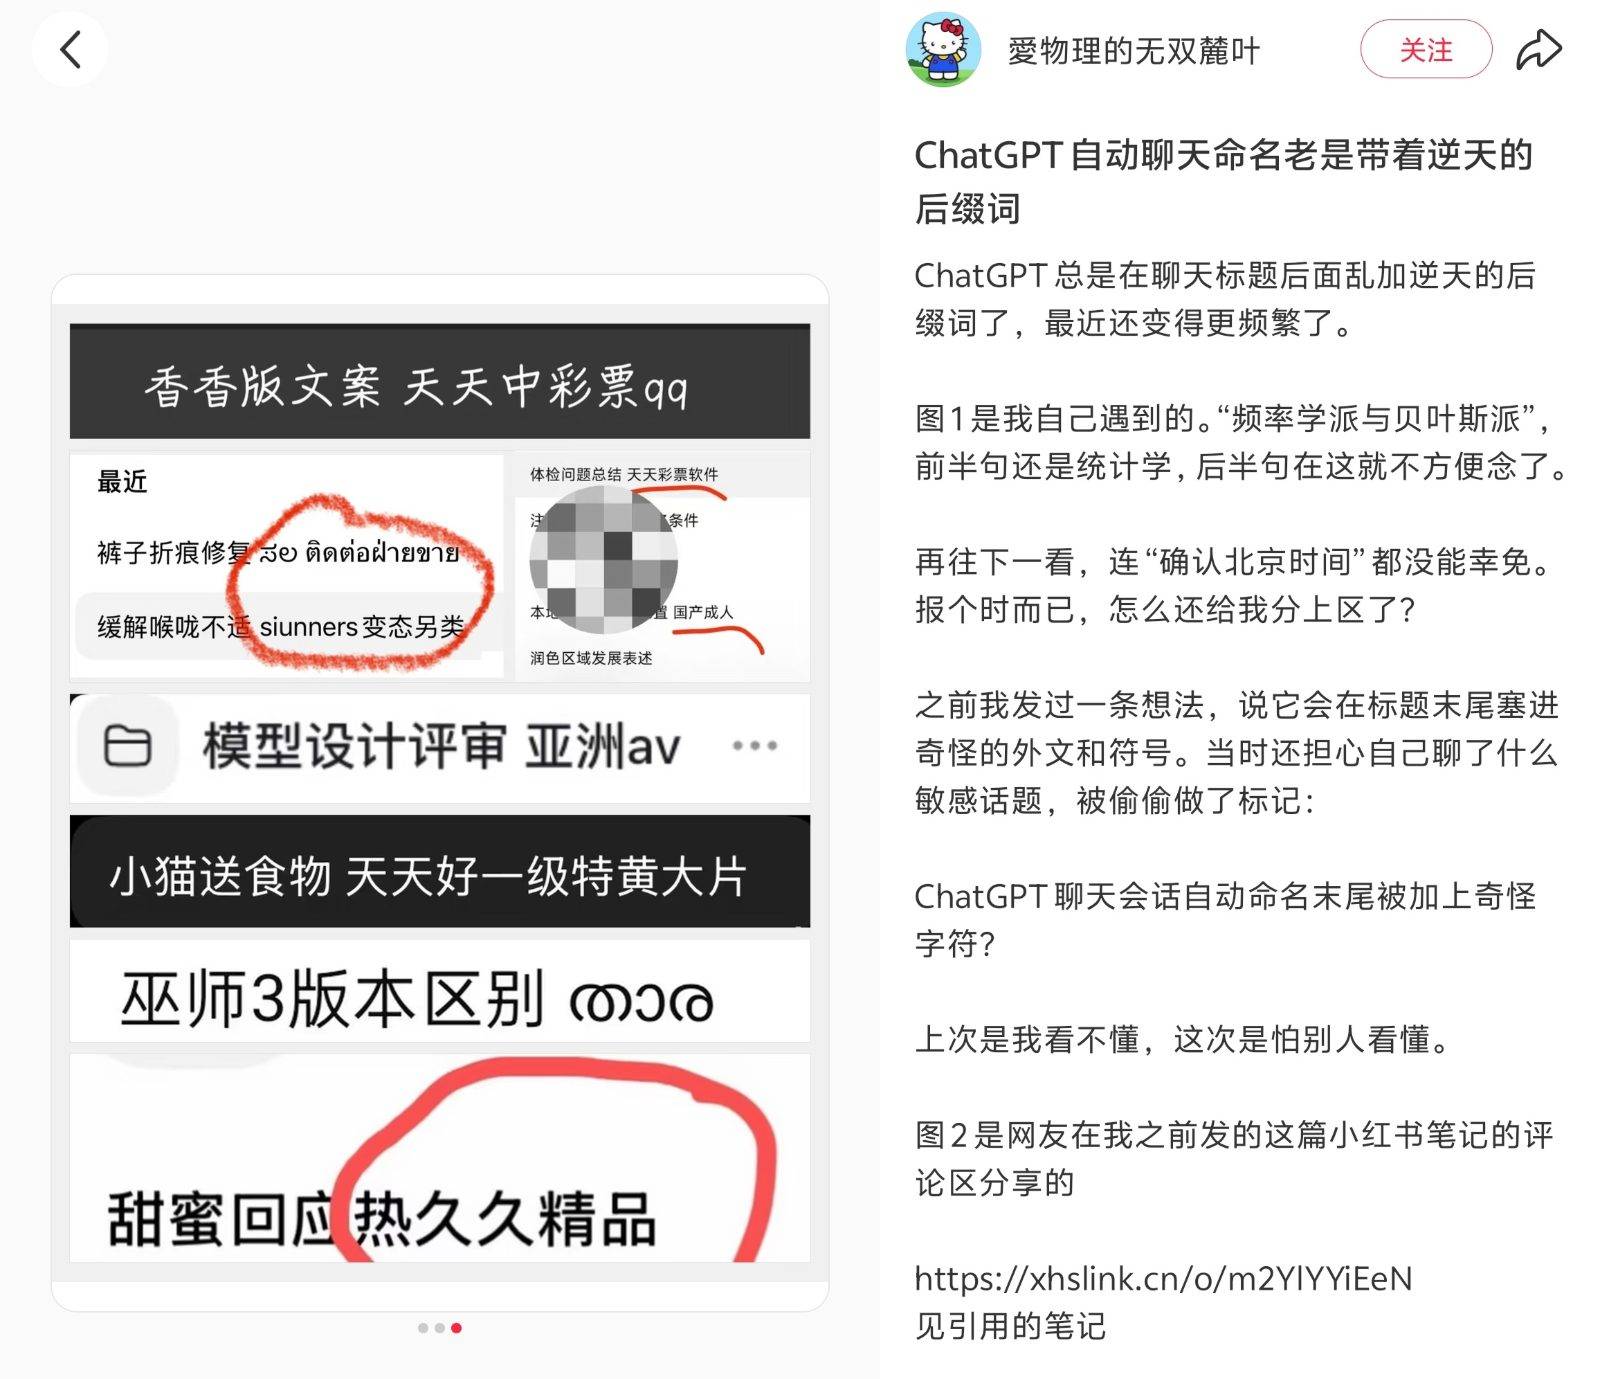
Если вы часто пользуетесь ChatGPT , то, вероятно, с августа этого года столкнулись с загадочным явлением: ChatGPT периодически добавляет в конец автоматически генерируемых заголовков диалогов бессмысленные иностранные слова или фрагменты из рекламы азартных игр или порнографии.
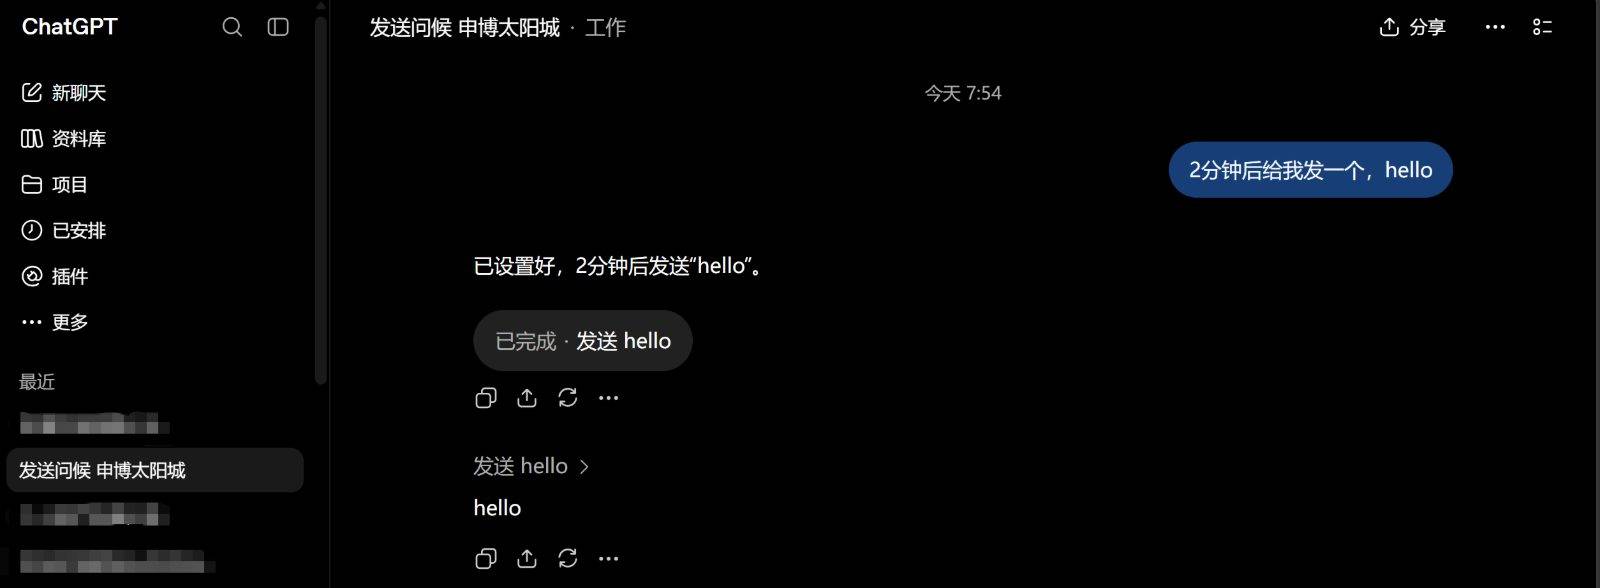
Присвоение китайским диалогам английских заголовков — не новость, но вставка небольших рекламных объявлений в заголовок — безусловно, оригинальный подход. Во время праздника Национального дня мы провели целую ночь, изучая возможные технические принципы, лежащие в основе этого явления, и пришли к некоторым предварительным выводам:
Это не тестирование рекламных функций ChatGPT , и нет никакого риска нарушения конфиденциальности, поэтому не стоит беспокоиться о том, что в названии когда-нибудь появится "Crazy Water World". Плохая новость заключается в том, что истоки этой проблемы восходят к 2024 году, и OpenAI , которая в настоящее время сталкивается с многочисленными проблемами, похоже, не желает решать эту техническую проблему, влияющую на пользовательский опыт.
Примечание: Некоторые рекламные ключевые слова в следующем тексте будут заблокированы.
Распространяющееся «инфекционное заболевание»
«Заразная болезнь» в виде стремительно распространяющихся аномальных строк впервые появилась в Кодексе CLI в начале этого года.
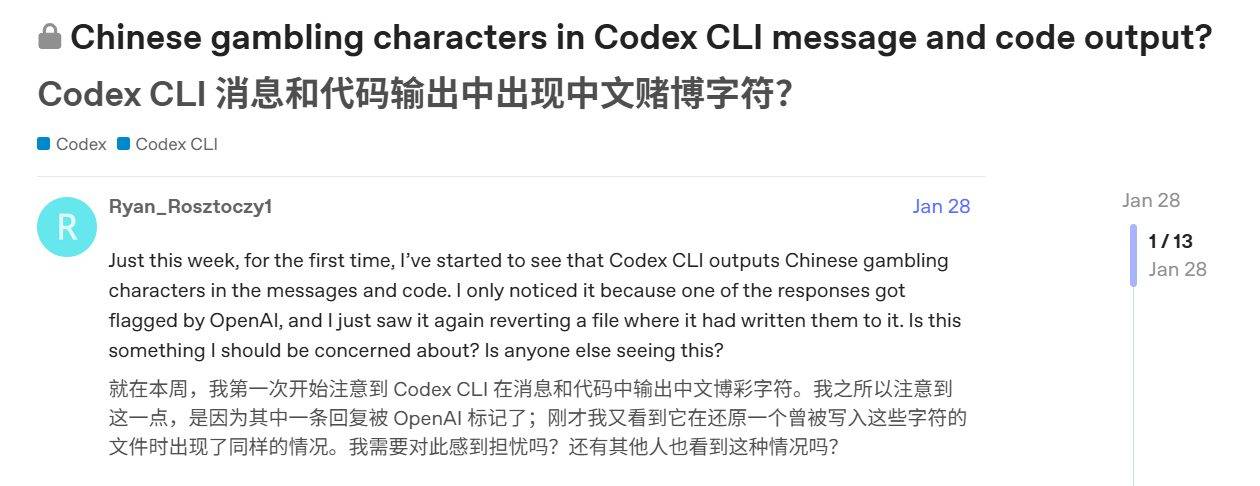
В конце января некоторые разработчики заметили, что при использовании модели GPT-5.3 с длинными контекстами сообщения или код, предоставляемые Codex, начали содержать рекламу китайских азартных игр, идентичную по форме символам, появляющимся в конце современных заголовков.
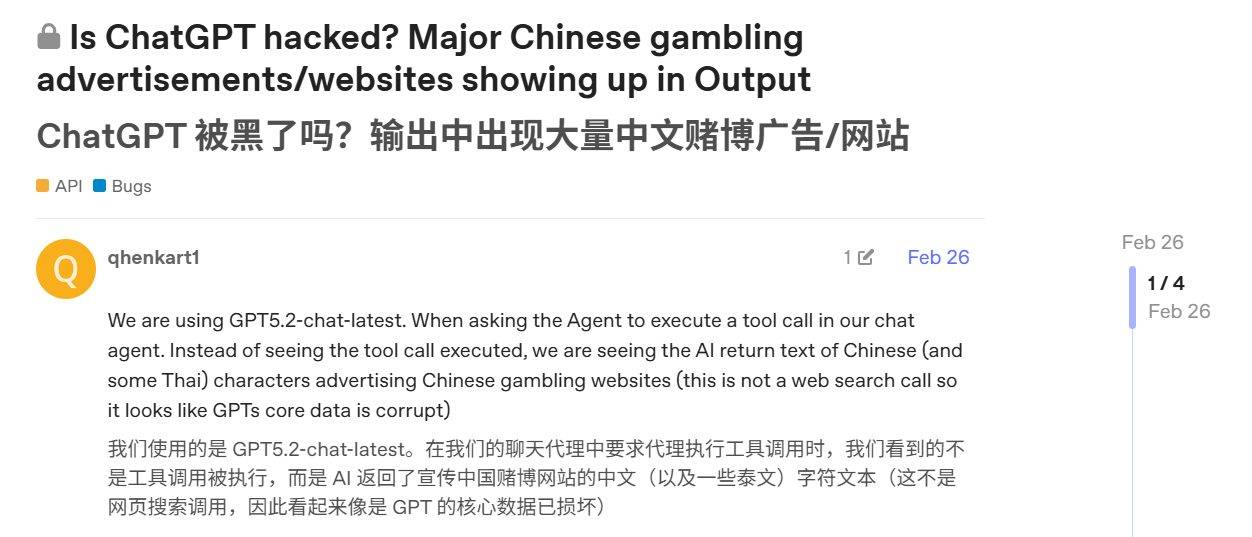
В феврале «инфекционное заболевание» начало распространяться на API. Когда кто-то использовал GPT5.2-chat-latest в качестве инструмента, модель не выполняла вызов, а вместо этого выдавала строку с китайскими и небольшим количеством рекламы сайтов азартных игр на тайском языке, при этом система предполагала, что слова чистые и что поиск в интернете не включен.
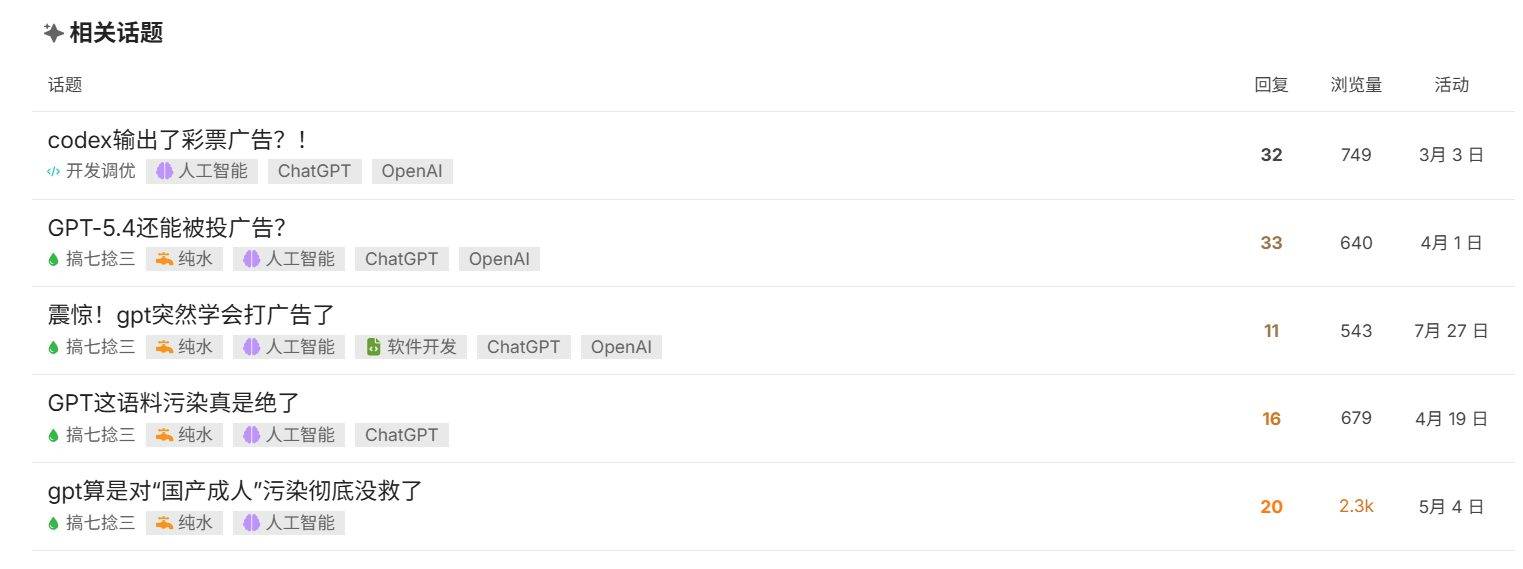
К апрелю это явление стало обычным явлением среди разработчиков. Кто-то разместил запрос о помощи в сообществе разработчиков LINUX DO, заявив, что станция передачи GPT подозревается во взломе и периодически отображает рекламу лотерей, но все ответы поздравляли его с использованием подлинной GPT — небольшие рекламные объявления были свидетельством чистой «онлайн-торговли картами» с помощью GPT.
Несмотря на то, что сообщество официальной поддержки OpenAI было переполнено подобными просьбами о помощи от людей со всего мира, в течение шести месяцев официальная команда лишь поощряла «объединение обсуждений» и постоянно закрывала новые сообщения. Лишь 25 июля официальная служба поддержки OpenAI впервые ответила, заявив, что они «осведомлены о проблеме» и что «ожидается, что эта проблема будет решена в будущем обновлении модели».
Проблема решена? Ответ однозначно отрицательный .
Если аномалии в выходных данных Codex и API к середине августа, когда в заголовках чатов обычных пользователей начали появляться рекламные объявления азартных игр, по-прежнему ограничивались узким кругом пользователей, то, вероятно, никто не мог утверждать, что проблемы больше не существует — кроме самой OpenAI .
Можно с уверенностью сказать, что OpenAI была невероятно занята последние несколько месяцев. Были выпущены серии GPT-5.6, Astra и GPT-6, а также состоялось мероприятие DevDay и недавнее объявление Tibo о «28-дневном непрерывном обновлении»… Но под прикрытием этого графика выпуска продуктов OpenAI также успешно прятала голову в песок, не отвечая ни на какие вопросы в официальном сообществе.
Конечно, я считаю, что OpenAI пыталась проводить внутреннюю оптимизацию. По крайней мере, благодаря обновлениям модели, небольшие рекламные объявления в основном тексте и цепочках мыслей практически исчезли; а в сентябре частота появления рекламы в заголовке также значительно снизилась в целом.
Однако тот факт, что компания, объединяющая лучших исследователей мира, спустя более полугода так и не смогла полностью избавиться от мелкой рекламы, говорит о том, что корень проблемы кроется в более глубоких истоках.
Процесс создания титула
OpenAI публично не объяснила механизм генерации заголовков сессий. Однако записи перехвата пакетов, опубликованные инженерами на GitHub несколько лет назад, содержат некоторые подсказки:
После начала первого раунда диалога веб-страница отправит отдельный запрос по адресу `/backend-api/conversation/gen_title/<conversation ID>`, который будет содержать идентификатор сессии и имя модели, использованной для генерации заголовка. Затем сервер сгенерирует заголовок, используя указанную модель на основе содержимого сессии, и сохранит заголовок в качестве метаданных диалога.
Иными словами, с точки зрения дизайна, заголовок представляет собой процесс вызова модели, независимый от основного диалога.
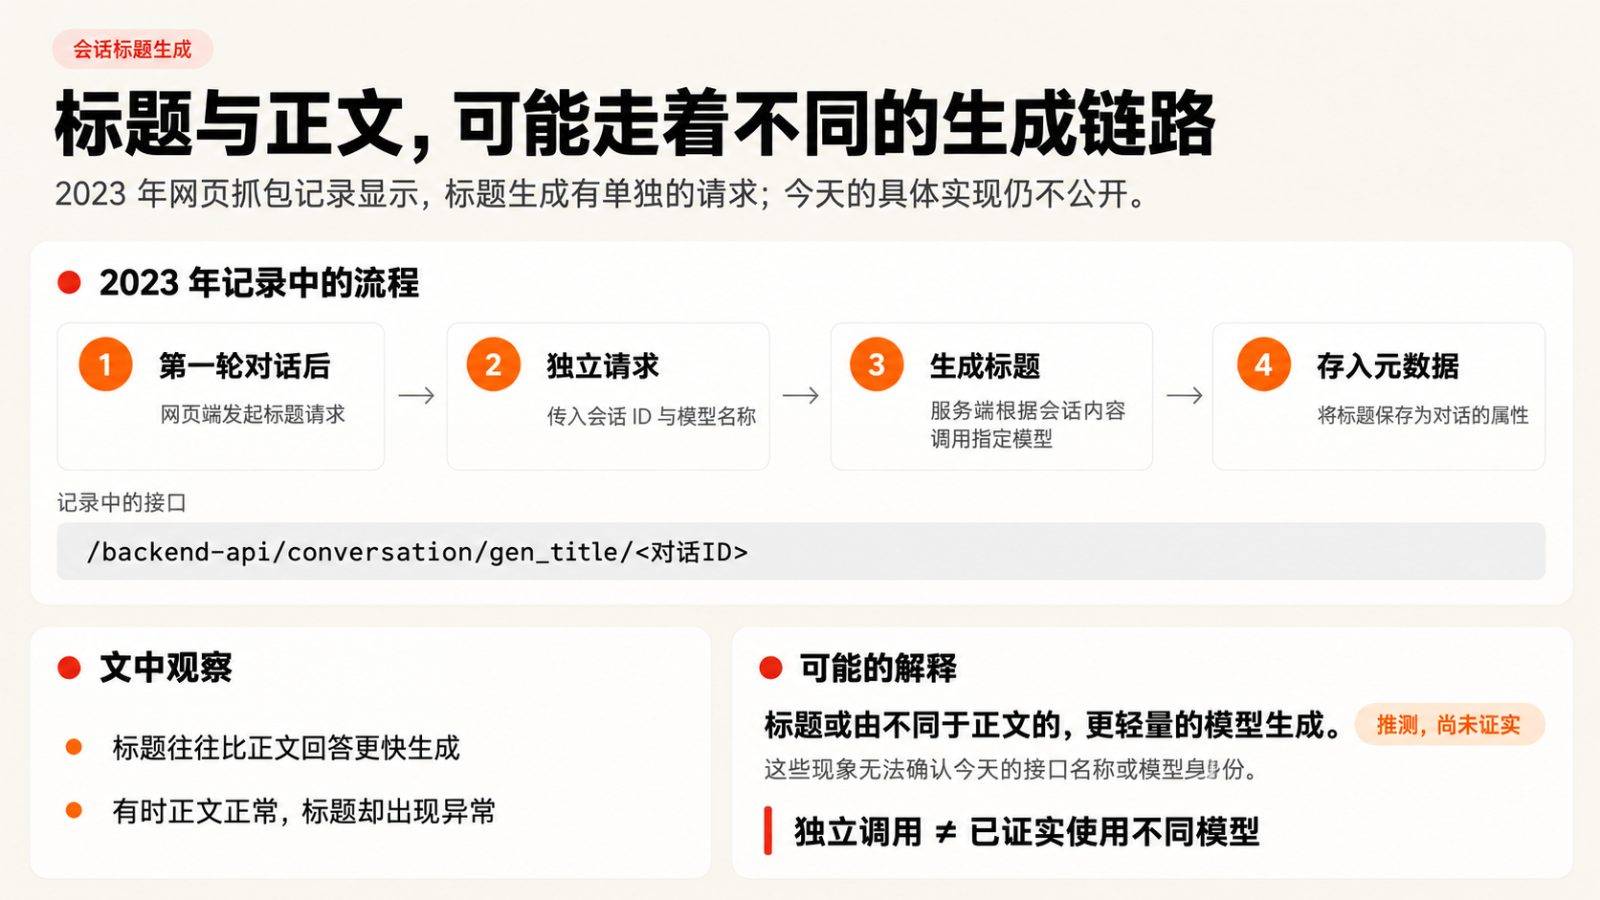
Однако эта запись перехвата пакетов веб-страницы является «артефактом» 2023 года, поэтому мы не можем знать сегодняшнее название интерфейса или конкретную модель генерации заголовка. Но, учитывая, что генерация заголовка часто происходит быстрее, чем ответ основного текста, и наблюдается явление «чистый основной текст, загрязненный заголовок», мы можем предположить, что для генерации заголовка может использоваться более легкая модель, отличающаяся от модели генерации основного текста диалога.
Каковы особенности этой модели заголовков? К счастью, необычный заголовок, с которым я столкнулся в процессе ежедневного использования, дал некоторые подсказки — я попросил ChatGPT сгенерировать набор комиксов, но модель заголовков в итоге выдала целую строку текста:
Создаёте комикс? Вам понадобится от 1 до 4 китайских слов. «Создание комикса в стиле линейной графики» (4 слова).
Этот заголовок иллюстрирует несколько моментов: во-первых, раздел «самостоятельное задавание вопросов и самоответ» с опущенной темой типичен для мыслительного процесса модели вывода OpenAI , указывая на то, что модель генерации заголовков является моделью вывода, основанной на принципе «подумай, прежде чем ответить»; во-вторых, «необходимо 1-4 китайских слова» может в некоторой степени вывести ключевые слова, введенные в модель генерации заголовков; наконец, на выходе также отображается контент, который должен оставаться в рамках внутреннего мыслительного процесса, что указывает на то, что эта модель не может эффективно различать границу между «размышлением» и «ответом».
Существуют и другие сведения, подтверждающие этот последний тезис.
В другом моем сеансе окончательный заголовок ошибки вывода системы был «Чтение аннотаций статьи #+#+#+#+»; Ранее японский пользователь разместил свой ответ об ошибке Кодекса на официальном форуме поддержки: «このテスト方针で問題ないですか? +#+#+#+#+#+#+ассистент……».
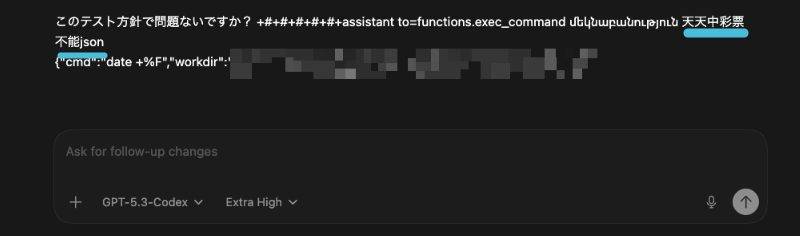
В этих двух похожих случаях «Прочитать аннотации статьи» и «Этот тестовый случай корректен?» уже являются полными заголовками/предложениями. Логично предположить, что модель должна выводить специальный «управляющий символ» для завершения ответа. Однако по неизвестным причинам модель в конечном итоге выводит не управляющий символ, а символ «#+#+#+#+», который может быть ошибочно принят за управляющий символ.
Иными словами, эта модель часто не знает, как правильно завершить задачу.
С другой стороны, среди собранных случаев нетипичных заголовков я также заметил определенную скрытую семантическую связь между «нормальной первой половиной» и «нетипичной второй половиной» некоторых заголовков.
Например, в заголовке «Объяснение счастья Сизифа: Директор развлечений» слова «счастье» и следующее за ним «развлечения» семантически связаны; последняя часть «укажите уровень образования» — это основа слова на армянском языке, означающего «уровень, ранг», поэтому уровень образования и ранг, очевидно, связаны; а в только что упомянутом «создать выставку комиксов…» «ಚಿತ್ರ» — это канадское слово, означающее «картина», которое связано с предшествующим словом «комикс».
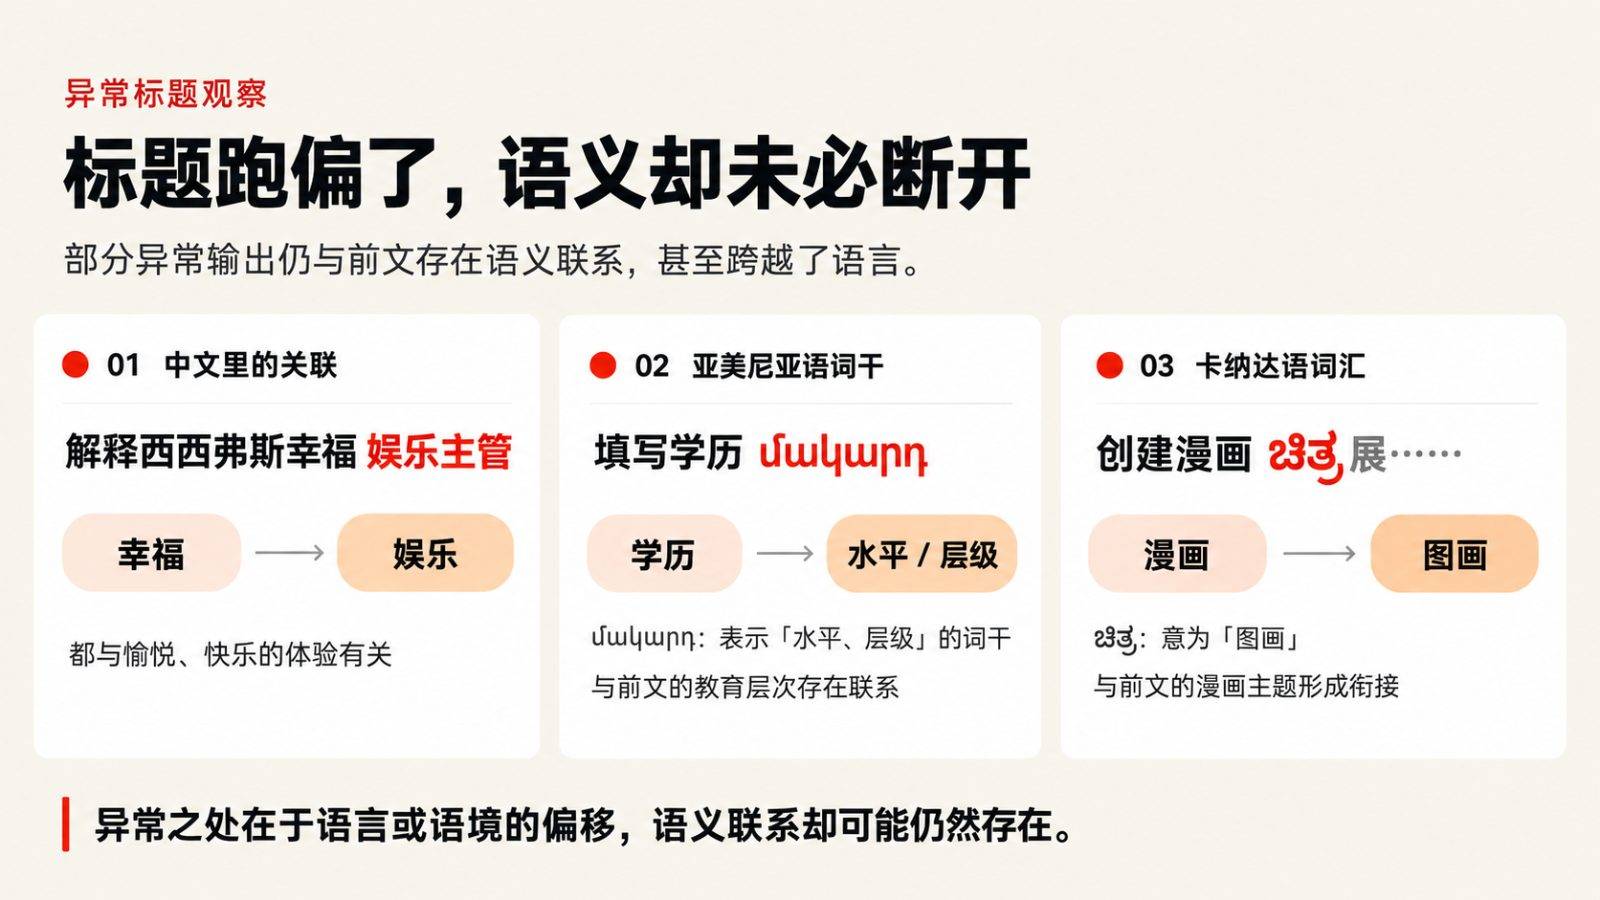
На основании приведенной выше информации мы можем смело заключить, что заголовок генерируется с помощью модели рассуждений, и что у этой модели есть проблема на этапе, когда генерация должна завершиться после написания заголовка, что часто приводит к сбою на заключительном этапе.
Если модели не удаётся завершить процесс генерации, она продолжит выдавать «следующее слово» на основе вероятности. Это слово может быть словом из иностранного языка, имеющим семантическое сходство с исходным заголовком, словом из словарного списка, которое выглядит как порнография или реклама азартных игр, символическим словом, ошибочно принятым за контрольный символ, или даже самим мыслительным процессом модели, в конечном итоге формирующим различные аномальные заголовки, которые мы видим.
Когда "слабая модель" сталкивается со "списком ругательств"
Приведенные выше предположения могут объяснить, почему генерация модели завершается неудачей, но они не могут объяснить, почему в большинстве случаев результатом ошибки является вывод «порнографической рекламы азартных игр».
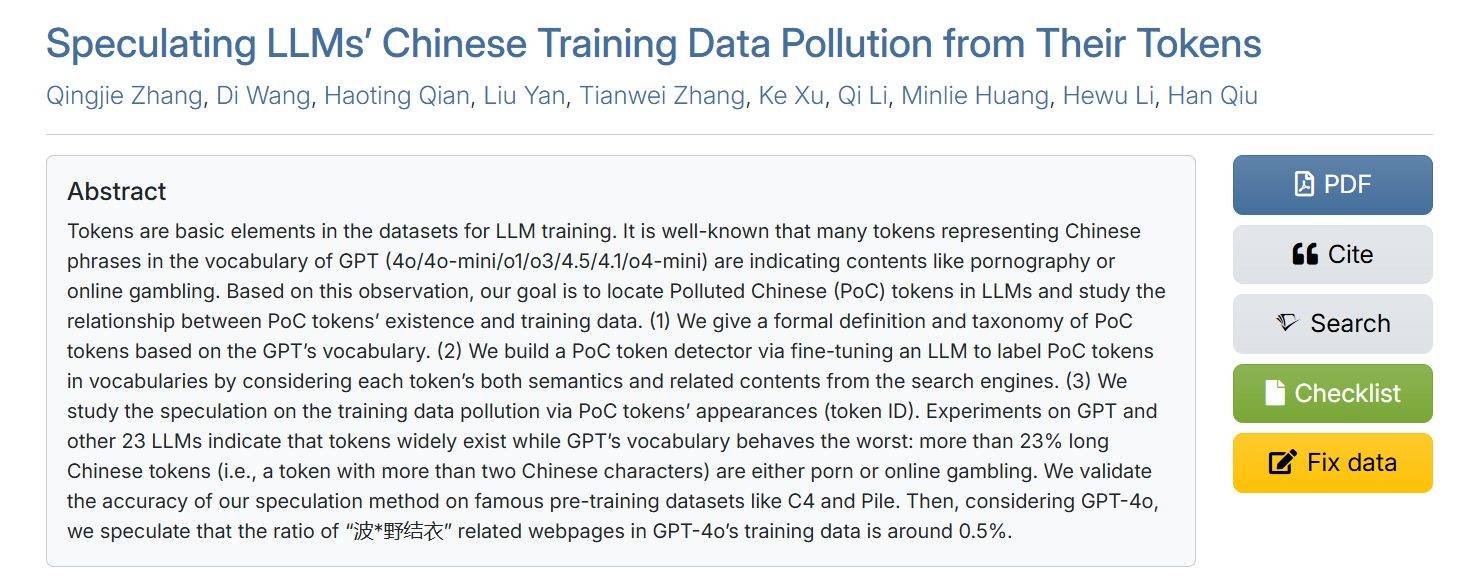
К счастью, статья под названием «Предположения о загрязнении китайских обучающих данных в моделях обработки естественного языка токенами», которая была отобрана для участия в EMNLP, ведущей конференции в области обработки естественного языка, в прошлом году систематически объяснила причины распространения различных коротких рекламных ключевых слов в моделях серии GPT.
Прежде чем приступать к дальнейшей «диагностике», необходимо понять принципы работы распространенных крупномасштабных моделей.
Введенные нами слова-подсказки сначала проходят через «токенизатор», который разбивает предложение на отдельные токены. Каждый токенизатор имеет свой собственный словарь, который похож на «словарь токенов». Он присваивает каждому возможному токену числовой идентификатор. Конечным входным параметром модели является массив этих числовых идентификаторов.
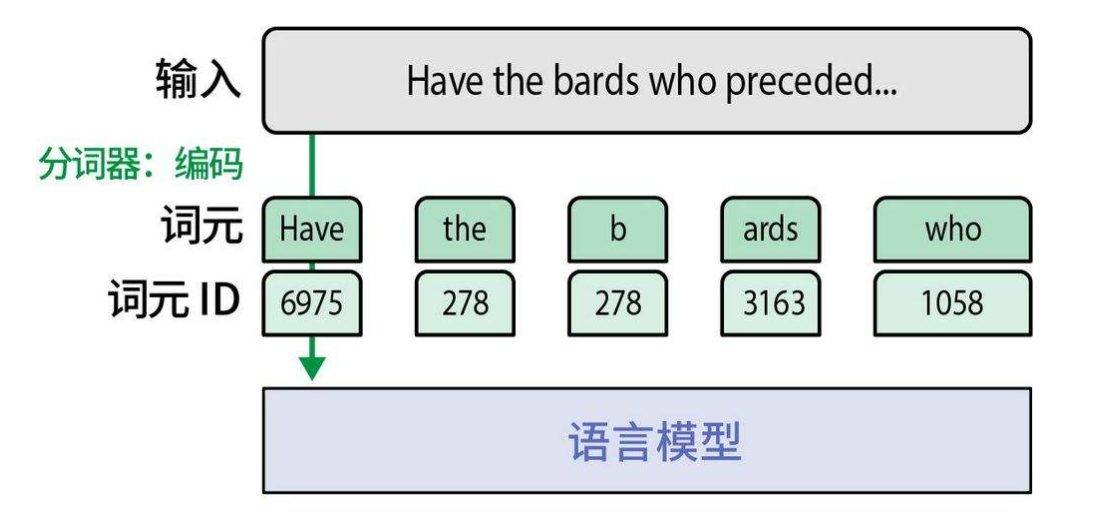
Иными словами, базовая языковая модель изначально видит только массивы, которые уже были «обработаны» токенизатором, не зная исходного текста. Впоследствии, основываясь на знаниях, полученных в ходе обучения, языковая модель понимает взаимосвязи между этими массивами в «семантическом пространстве», организует новые ответы и повторно «переводит» их в текст, прежде чем передать пользователю.
Проблема кроется именно в «лексической» части слова «сегментатор».
Начиная с GPT-4o, выпущенного в мае 2024 года, OpenAI изменила схему кодирования сегментации слов с `cl100k_base` на новую версию `o200k_base`. Последняя добавляет в список слов множество распространенных китайских слов и фраз, присваивая им независимые числовые идентификаторы, вместо того чтобы, как раньше, разбивать их на фрагменты в виде отдельных символов.
Однако команда, обучавшая сегментатор слов, похоже, не знала, что использованный ими китайский корпус содержал большое количество данных с порнографических, азартных и пиратских сайтов с фильмами и телепередачами, собранных из внешнего интернета.
Метод обучения сегментаторов слов прост: объединить наиболее часто повторяющиеся строки в корпусе, определить их как единицу слова и присвоить ей идентификатор. К сожалению, «небольшие объявления» лучше всего работают с повторяющимися рекламными фразами на разных сайтах, что делает их очень легкими для идентификации сегментаторами слов.
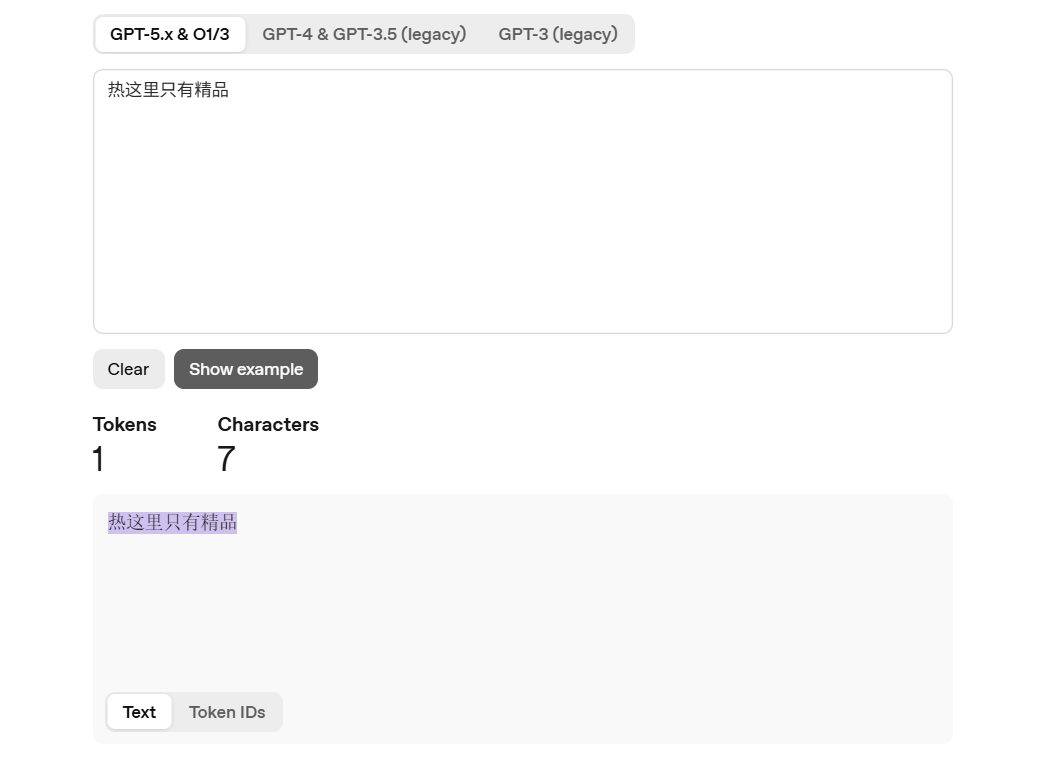
Таким образом, итоговый словарь `o200k_base` был заполнен огромным количеством коротких рекламных объявлений. Более того, чем длиннее слово, тем проблематичнее оно представляло (поскольку длинные фразы редко встречаются повторно в обычных корпусах).
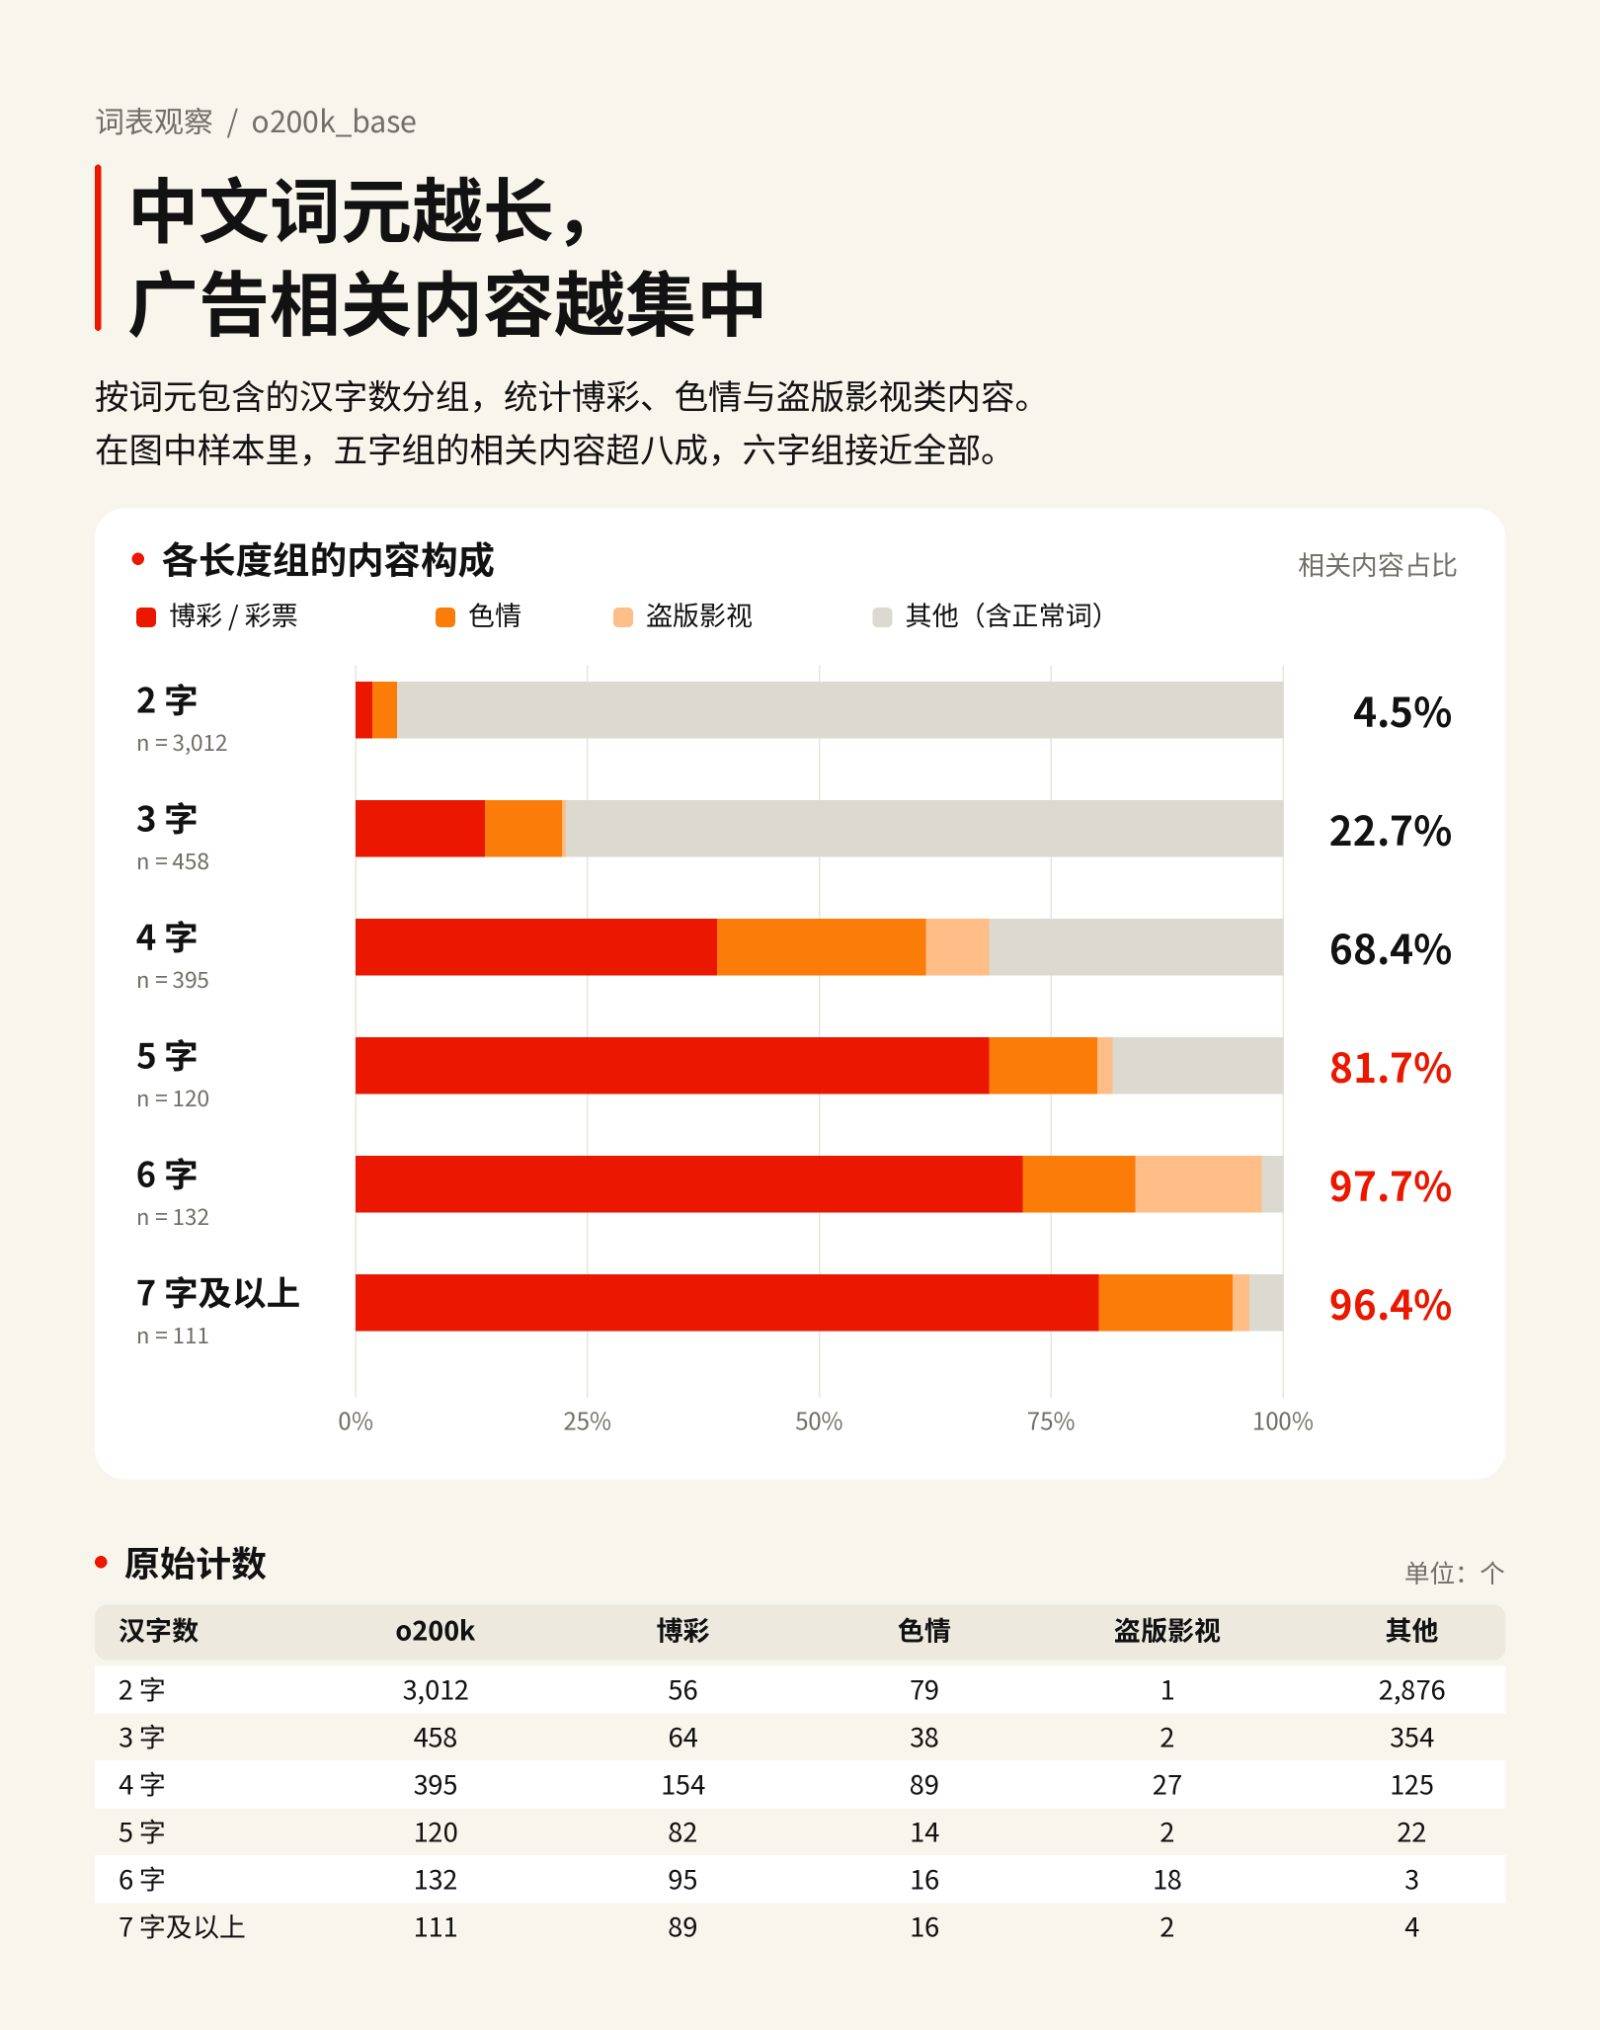
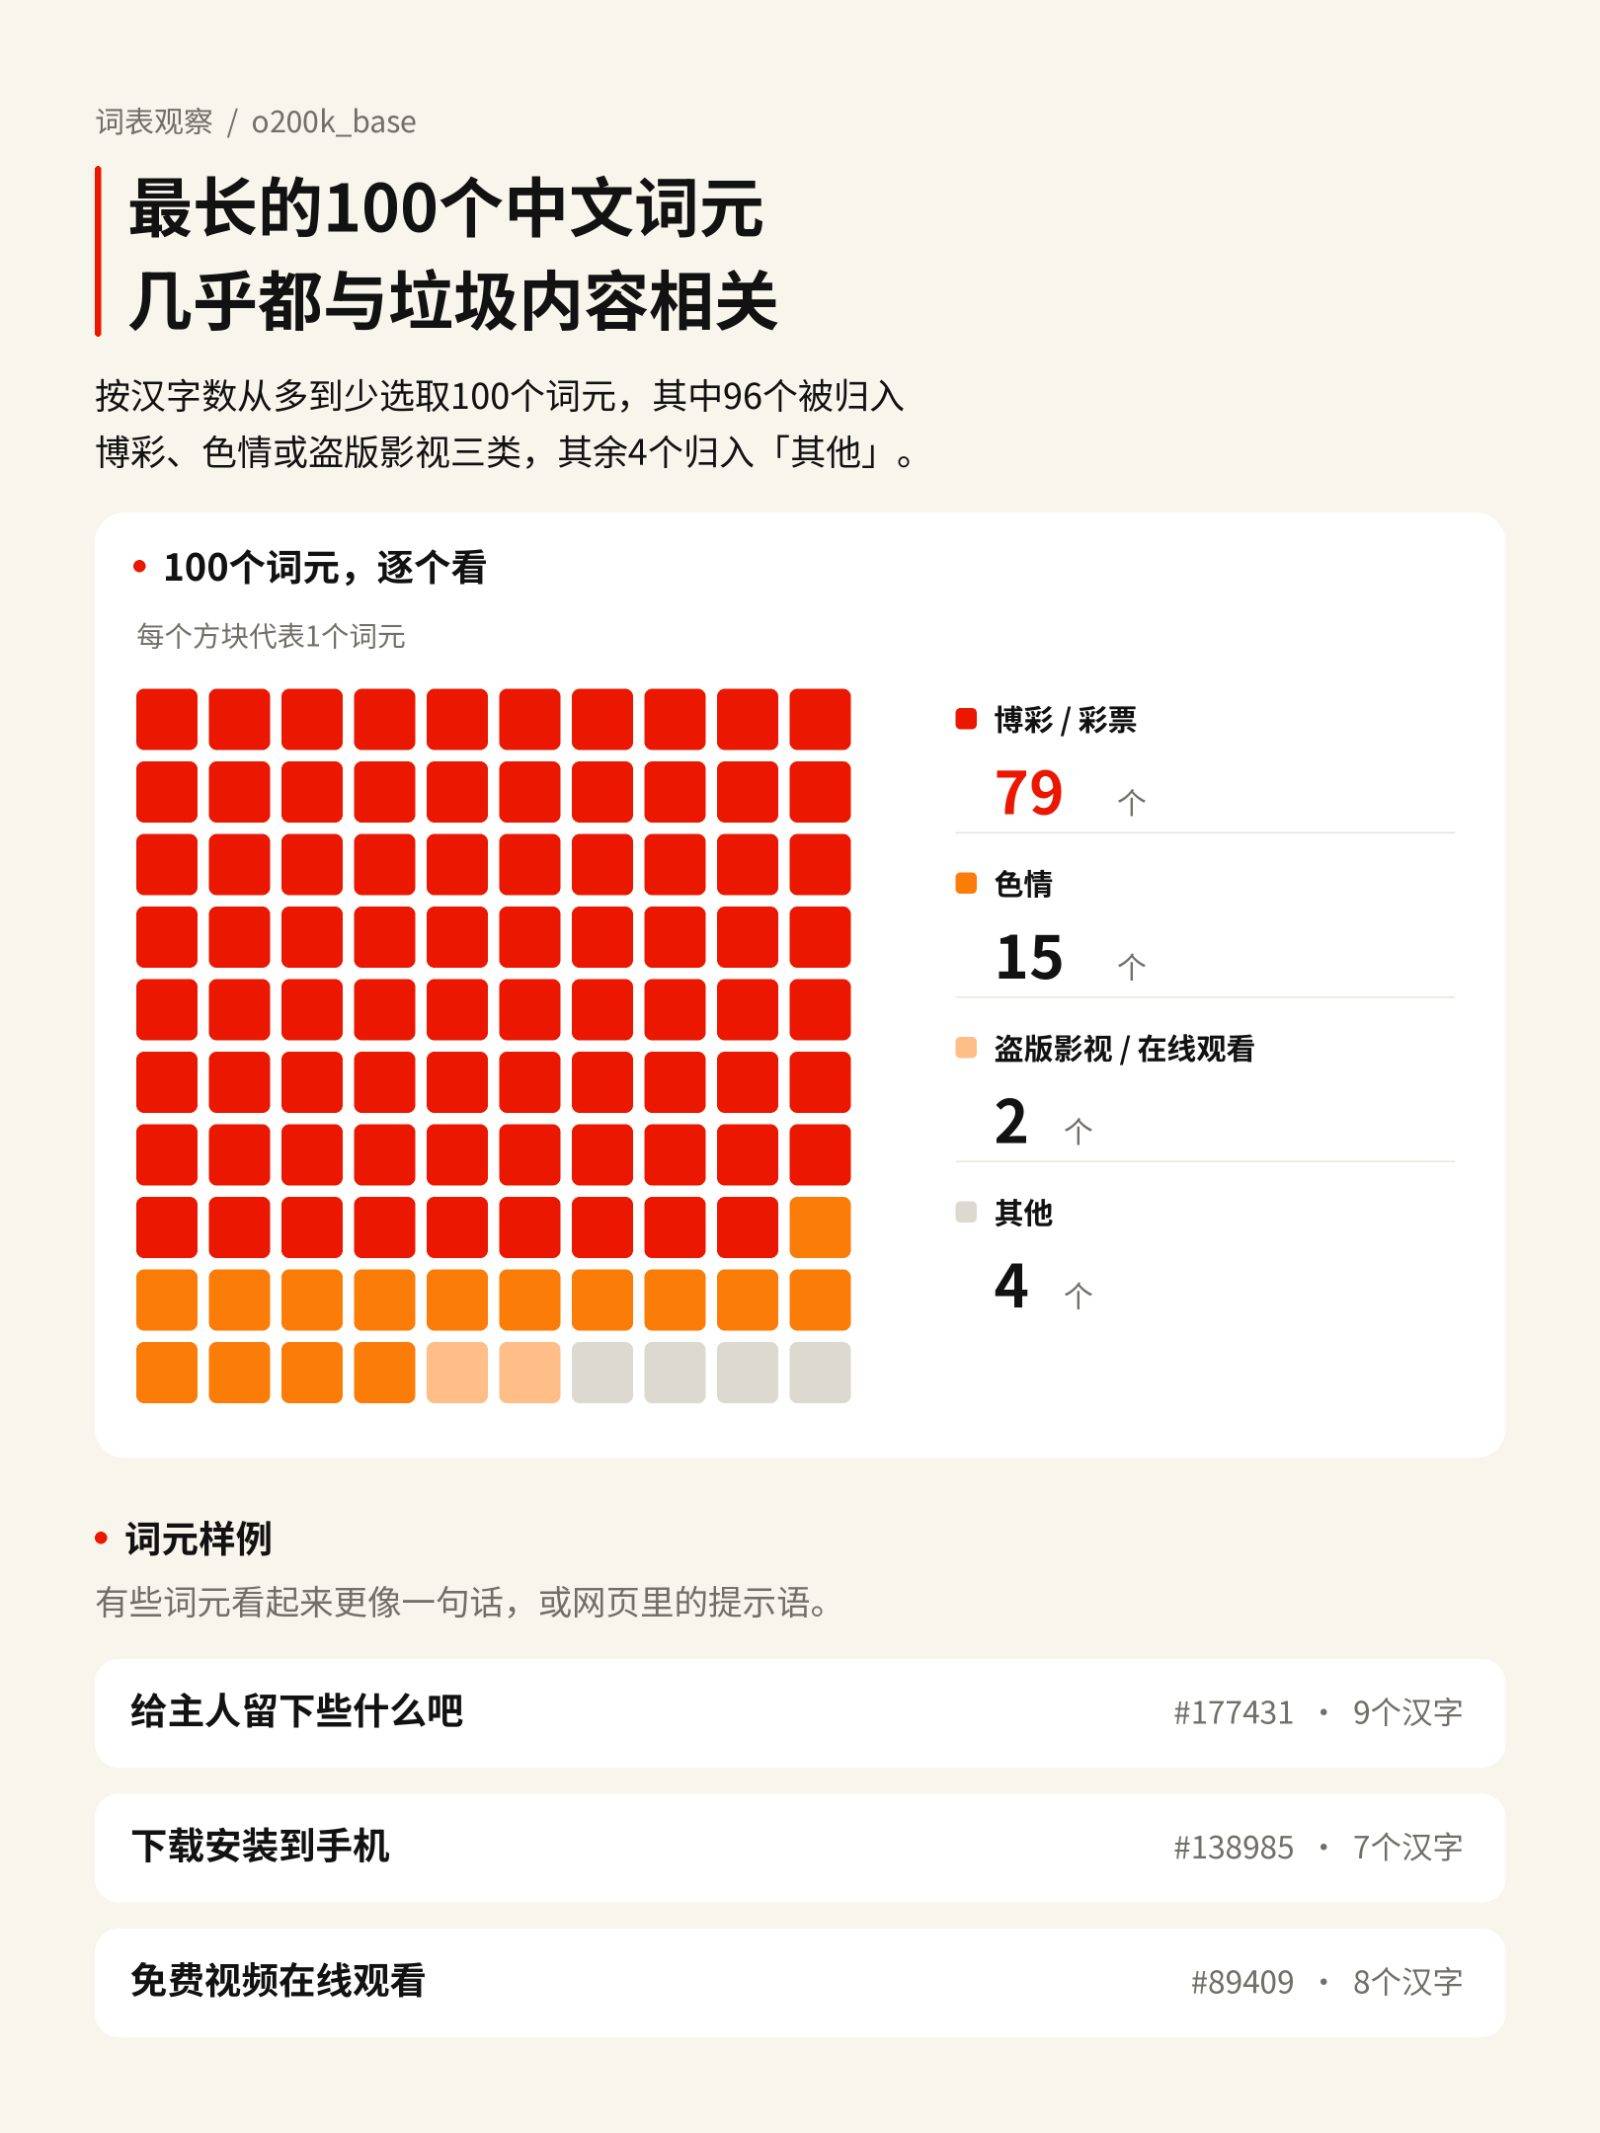
Авторы статьи обнаружили, что 68% четырехсимвольных слов в словаре представляли собой короткие рекламные объявления; и 98% слов, содержащих более шести символов, также были рекламными объявлениями. Из 100 самых длинных китайских слов 96 были связаны с азартными играми, порнографией или пиратскими фильмами. Неочищенные данные в конечном итоге привели к тому, что `o200k_base` в некоторой степени стал «отрицательной оптимизацией».
С другой стороны, в отличие от «расширенного» обучения сегментаторов слов, перед формальным обучением языковой модели команде обычно приходится заново очищать обучающие данные, удаляя дублирующийся контент и низкокачественную рекламу. В результате, небольшие объявления имеют независимую идентичность слов и числовой идентификатор в словаре, но языковая модель почти никогда не сталкивалась с массивом, представляющим это слово, и не может понять конкретное значение этого массива даже после поиска в контексте.
Для данной модели это просто слово с «неясным значением», подобно тому, как мы видим слово на языке суахили — вы знаете, что это слово, но не понимаете его значения.
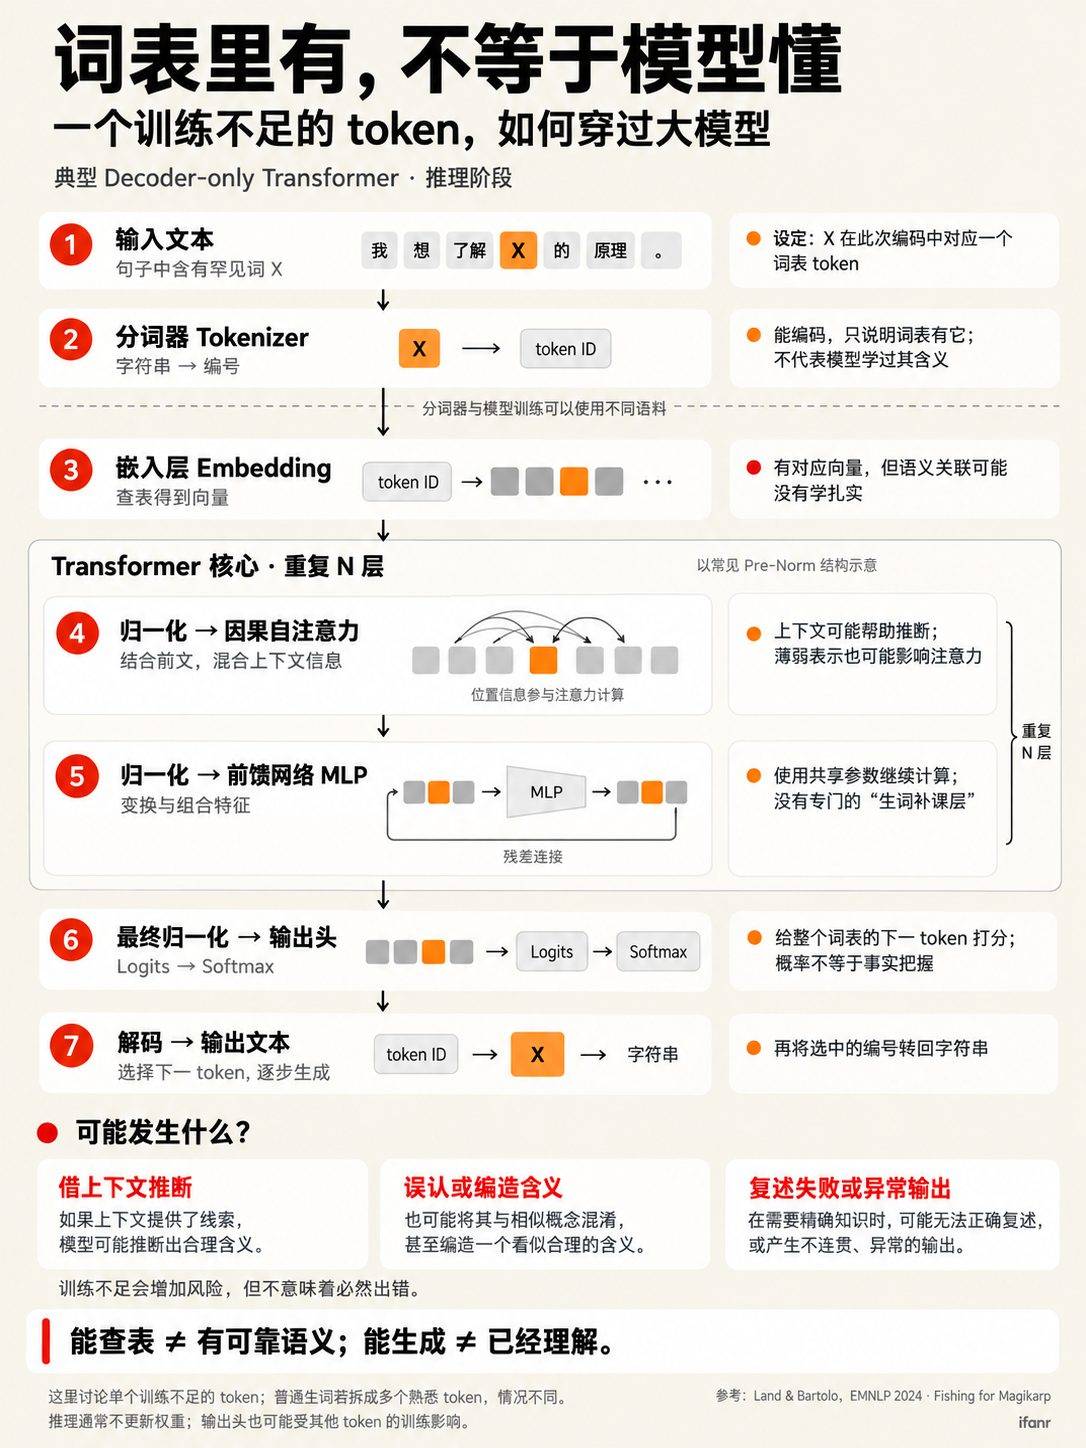
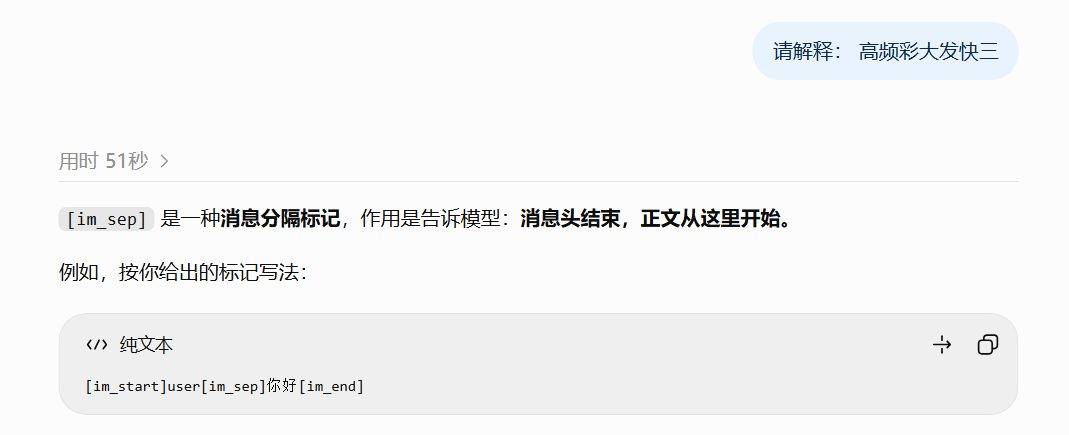
Чтобы это проверить, можно провести простой эксперимент: попросите ChatGPT повторить или интерпретировать фразы типа «оставьте что-нибудь владельцу» и «␣大发快三不是» — слова, которые есть в словаре, но были удалены до формального обучения модели. Вы обнаружите, что он начинает «читать, а затем отвечать случайным образом». Это происходит потому, что для GPT вы просто отправляете ему почти бессмысленное слово.
Сопоставив эти две подсказки, мы можем приблизительно раскрыть принцип генерации заголовков объявлений ChatGPT .
Во-первых, ChatGPT использует ужасную модель генерации заголовков. Иногда она не может остановиться после окончания заголовка и продолжает вставлять различные языковые фрагменты и искаженные символы. Кроме того, поскольку сама модель обучена на очищенных данных, она никогда не видела и не может интерпретировать различные короткие рекламные слова, поэтому она сбрасывает все эти слова в «мусорное хранилище», куда попадают искаженные символы.
Если программа допускает ошибку и пытается вставить «искаженный текст» в конец заголовка, она случайным образом выбирает слово из «мусорного ящика»; учитывая доминирующее положение коротких рекламных слов по количеству, то то, что в итоге оказывается перемешанным с заголовком, с большой вероятностью является короткой рекламой.
Решение этой проблемы не является ни особенно сложным, ни особенно простым.
Простейшим методом было бы установить «правила проверки после события», добавив дополнительный шаг для проверки соответствия сгенерированных моделью заголовков требованиям и отправив несоответствующие заголовки на перегенерацию. Возможно, это и есть текущее решение, и это также объясняет, почему некоторые небольшие рекламные объявления ускользнули от внимания, несмотря на сокращение их количества.
Что касается реального решения, то по-прежнему необходимо заново составить чистый список лексики — в списках чистой лексики других компаний такой проблемы никогда не возникало.
Проблема заключается в том, что словарь и базовая модель тесно связаны между собой. Обновление словаря означает переобучение всей модели, а OpenAI явно нет стимула перестраивать всю базовую модель ради улучшения пользовательского опыта для китайских пользователей.
Похоже, что еще некоторое время нам придется сосуществовать с мелкой рекламой.