Искусственный интеллект, который не умеет читать, но очень хорошо умеет говорить
Общение с ИИ с помощью голоса — не новость, но в основе работы большинства голосовых помощников на рынке лежит «чтение по сценарию»: сначала речь человека преобразуется в текст, затем большая текстовая модель обрабатывает его, и, наконец, текст зачитывается вслух с помощью технологии синтеза речи.
Dessa, голосовая модель, разработанная бывшим сооснователем Twitter, полностью обходит стороной текстовый мост и пытается доказать, что знания и разговорные способности машины могут развиваться непосредственно из самого звука.
«Раз человеческие младенцы учатся говорить раньше, чем читать, почему машины не могут пойти по тому же пути?» С этим убеждением Джек Дорси создал лабораторию искусственного интеллекта. Джек Дорси — один из основателей X (ранее Twitter), а сейчас владеет компанией Block, основной деятельностью которой являются финансовые платежные продукты, такие как Square и Cash App. Десса возглавляет исследовательскую группу в Block, занимаясь исключительно исследованиями в области искусственного интеллекта и подчиняясь непосредственно основателю Джеку Дорси.
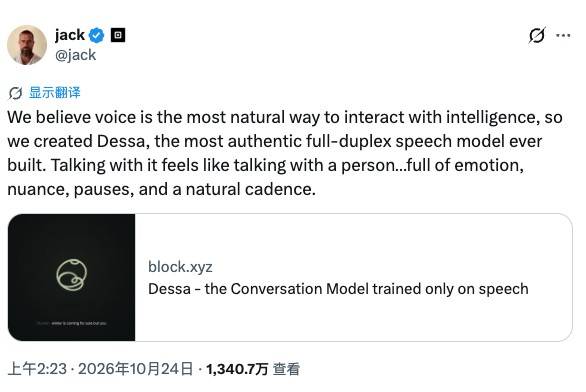
Текст был исключен из процесса обучения, поскольку он естественным образом отфильтровывает много информации. Текст фиксирует предложение в виде статической строки символов, в то время как звук каждый раз звучит по-разному. Команда Block заявила, что Десса, выросшая в окружении звуков, не только может слушать и говорить одновременно, естественно вставлять реплики и давать утвердительные ответы, такие как «э-э» и «да», но даже может работать локально на MacBook Pro, оснащенном чипом M4 Max.
Ограниченные нераскрытыми деталями обучения и размером модели, посторонним сложно оценить верхний предел этого технического подхода, но он указывает на «нетрадиционный» путь, который долгое время оставался в тени больших текстовых моделей: преобразование речи в речь.
Оно умеет говорить, а затем отвечать на телефонные звонки.
Если Dessa представляла собой чисто лабораторное исследование сущности речи, то одновременно с этим другой прагматический подход к моделированию речи быстро входил в повседневную рабочую практику.
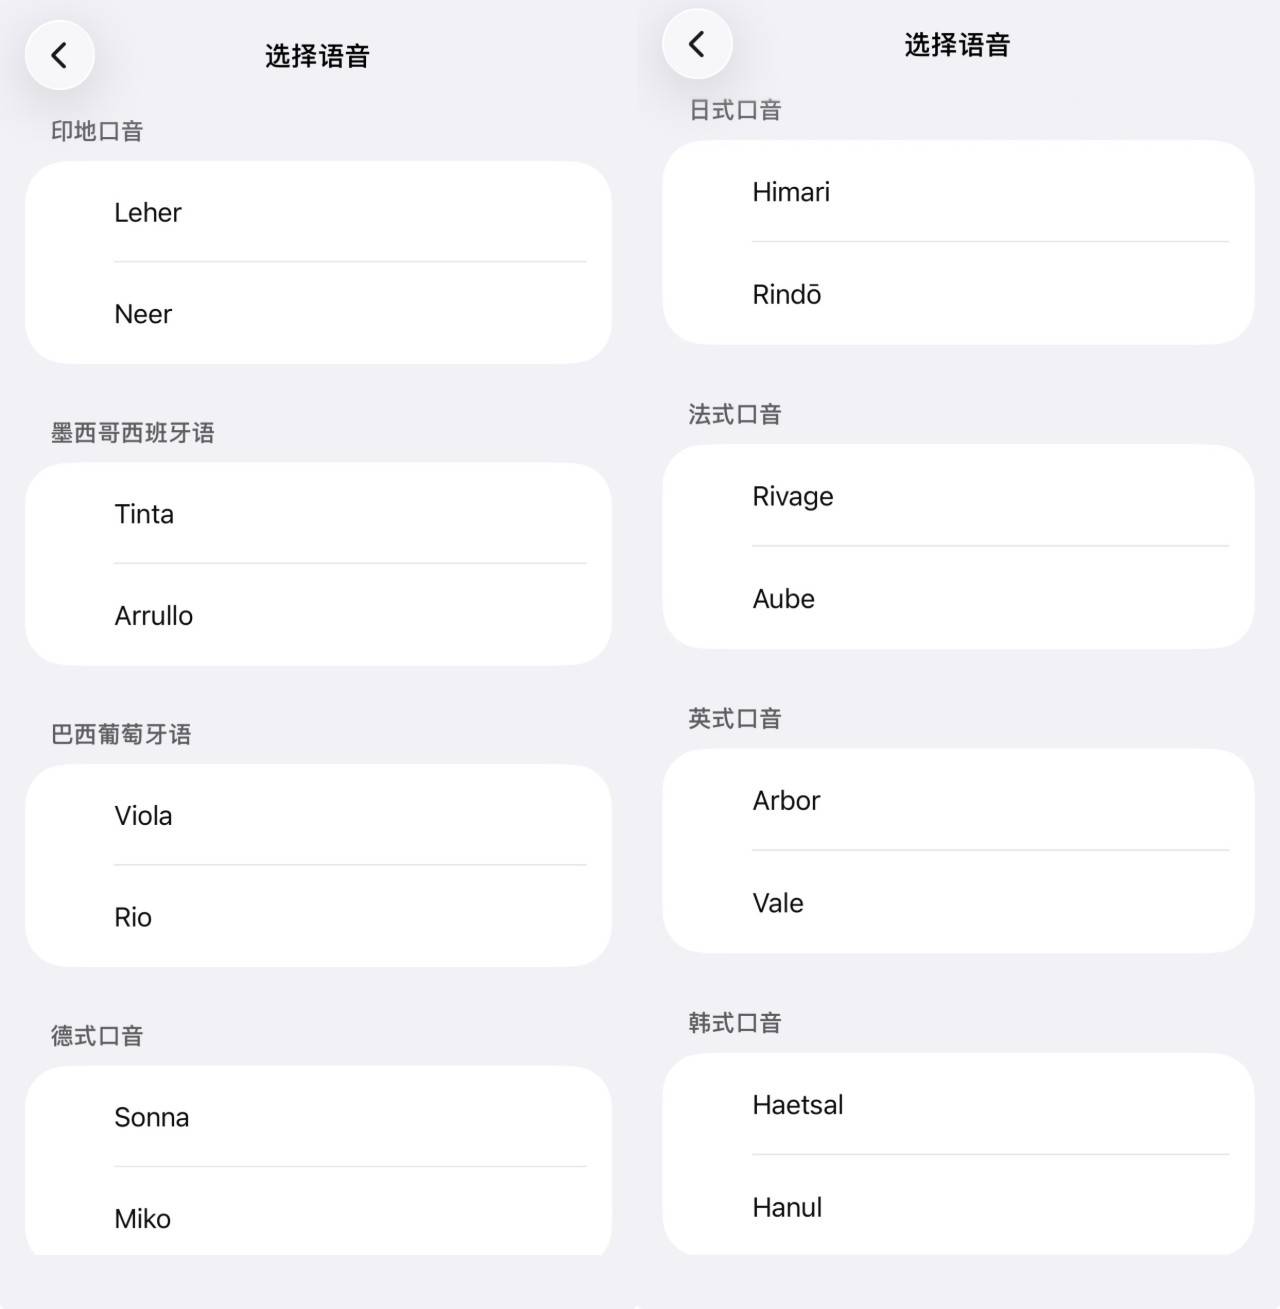
В середине октября OpenAI обновила свою речевую модель GPT-Live, не только улучшив естественность многоязычных акцентов в клиенте ChatGPT , но и добавив девять новых голосов, включая японский, корейский и английский акценты, в API для разработчиков, а также поддержав настройку голосов путем прямого описания их текстом.
Практически одновременно компания xAI также запустила Grok Voice 3.0, которая также ориентирована на сквозное голосовое взаимодействие в реальном времени (передача речи от начала до конца).
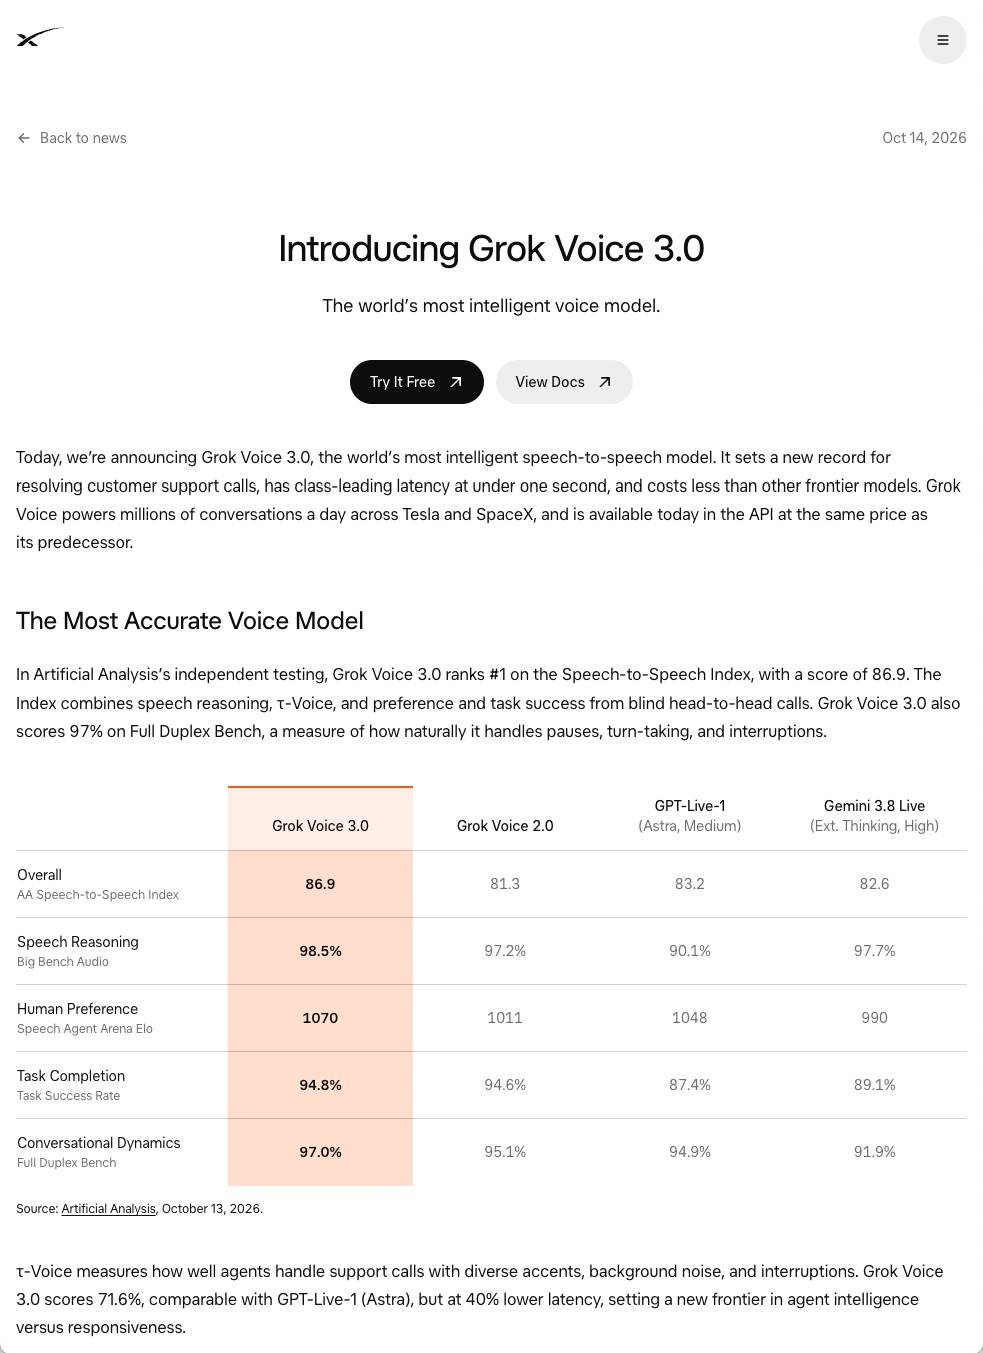
В отличие от обсессивно-компульсивного подхода Дессы к обучению, который «полностью избегает текста», основные коммерческие модели, представленные Grok, больше заинтересованы в сочетании основ текстового мышления крупных моделей с возможностями носителя речи, чтобы голос можно было действительно использовать по назначению.
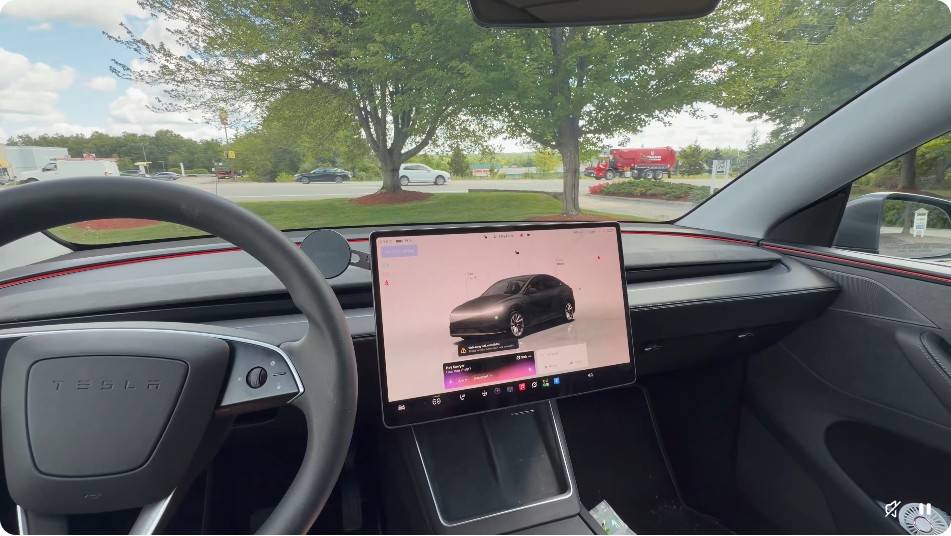
Взяв в качестве примера Tesla, владельцы автомобилей могут общаться с Grok напрямую через информационно-развлекательную систему автомобиля, не открывая при этом свои телефоны или приложения отдельно.
Интересно, что эволюция этих распространенных моделей речи вращается вокруг крайне тонкого временного промежутка: полсекунды.
При наборе текста на клавиатуре ожидание в полсекунды практически не влияет на характер разговора; однако по телефону полсекунды тишины достаточно, чтобы полностью перевести разговор в другую крайность. Именно поэтому, даже если ответ ИИ безупречен, если он жёстко ждёт, пока собеседник закончит говорить, прежде чем прервать, смеётся в неподходящие моменты или упрямо читает весь текст после прерывания, пользователь мгновенно теряет погружение в разговор. В обзоре Grok Voice 3.0 целевым показателем оптимизации была полсекунды.
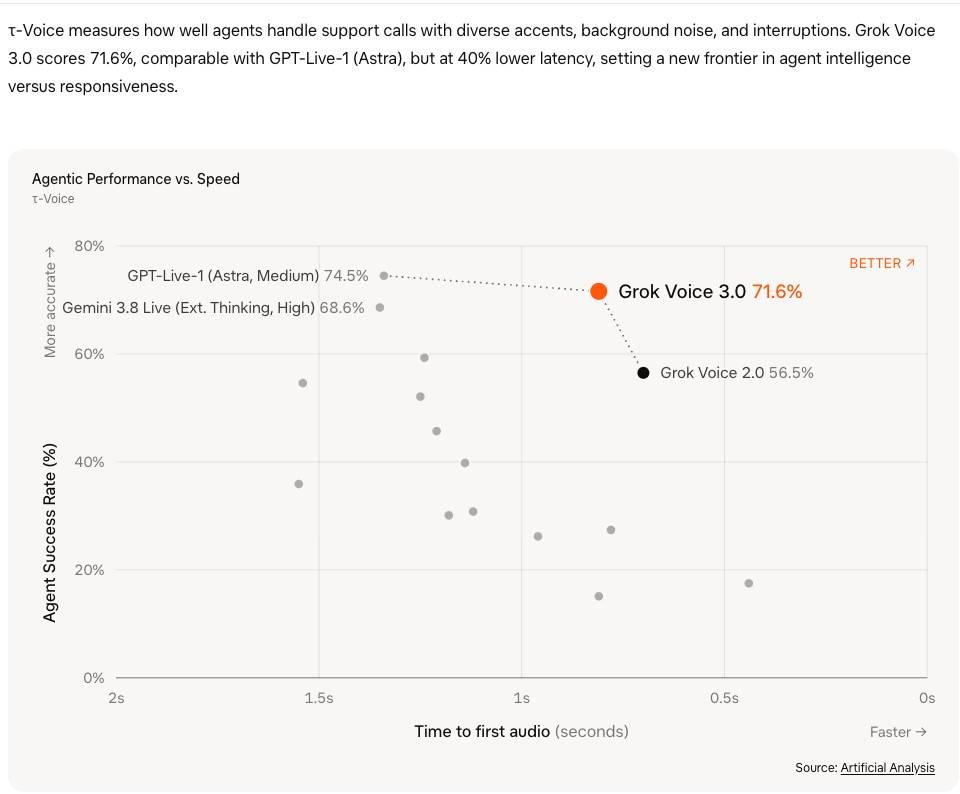
Разница в миллисекундах может напрямую влиять на практическое коммерческое применение. В настоящее время наиболее эффективными сценариями применения голосового ИИ являются салоны автомобилей и горячие линии обслуживания клиентов. Согласно внутренним операционным данным, опубликованным xAI, помимо обработки огромного количества разговоров в автомобилях Tesla ежедневно, эта голосовая система также обрабатывает около 20 000 звонков в службу поддержки Starlink каждый день, при этом около 70% проблем решаются без передачи оператору-человеку.
Помимо скорости, модель должна уметь четко понимать запрос звонящего, несмотря на акцент, фоновый шум и частые перерывы; она должна уметь беспрепятственно получать информацию, получать доступ к инструментам и обрабатывать ошибки в фоновом режиме; и, наконец, она должна вежливо завершать разговор. Все эти операции должны выполняться безупречно, в сочетании с естественным голосом, чтобы модель действительно соответствовала критериям "на дежурстве".
Почему звук из научно-фантастического фильма не является основным интерфейсом компьютера?
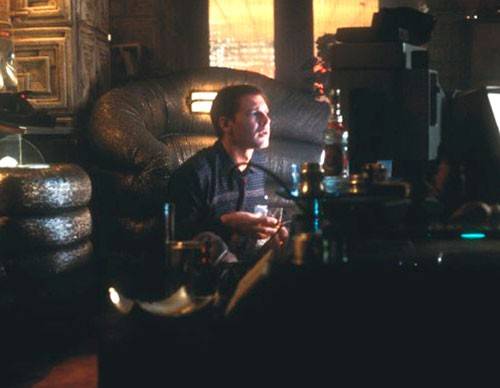
Увлечение человечества компьютерами с голосовым управлением имеет давнюю историю. Еще в фильме «Бегущий по лезвию» главный герой Декард отдавал команды анализатору изображений, заставляя изображение перемещаться и увеличиваться, пока он не находил скрытые подсказки.
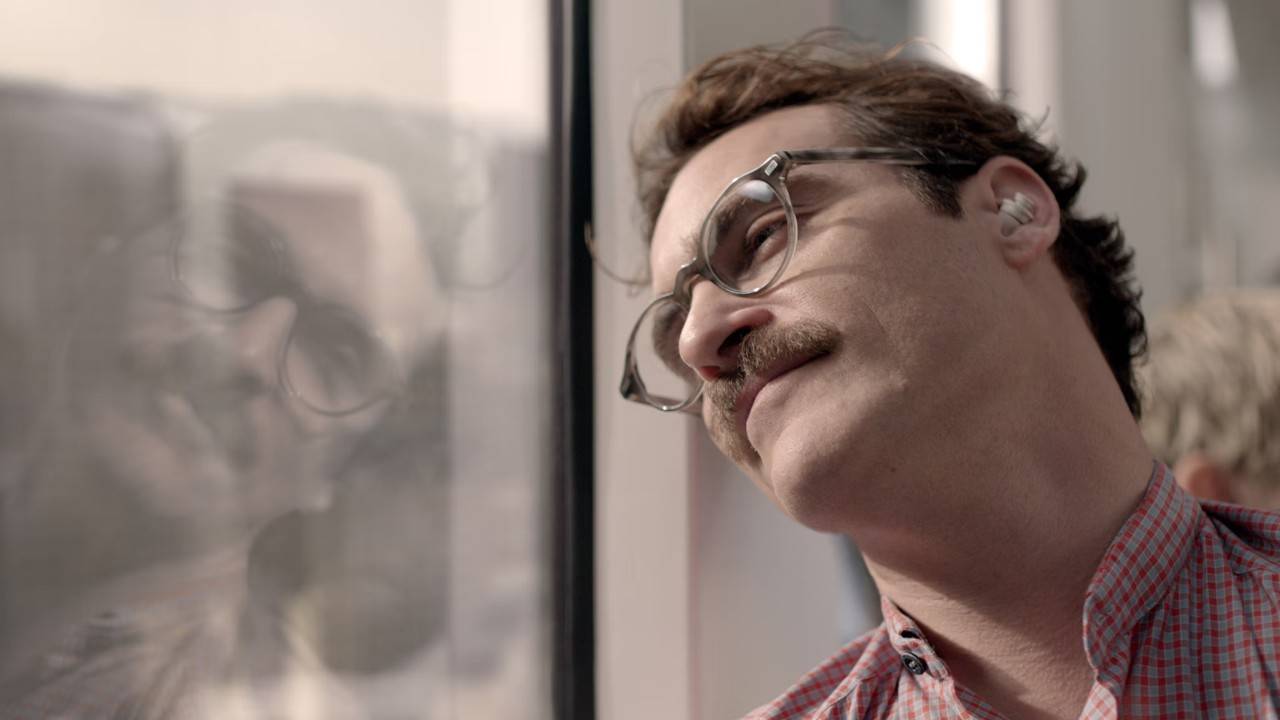
В игре *Her* операционная система Саманта делает еще один шаг вперед, превращаясь из машины, выполняющей инструкции, в постоянного компаньона и родственную душу. Она не только способна выполнять все повседневные задачи, но и обладает невероятно выразительным голосом, что позволяет ей развивать романтические отношения с главным героем.
В действительности эволюция технологий воплотила в жизнь первоначальные замыслы. На заре своего существования голосовые помощники в мобильных телефонах могли обрабатывать только простые команды с фиксированной структурой предложений, такие как установка будильника и проверка погоды. После появления умных колонок в гостиных, их наиболее распространенными задачами стали воспроизведение музыки и установка таймеров обратного отсчета. Только с объединением больших языковых моделей с голосовыми агентами машины действительно стали понимать свободную устную речь и начали помогать пользователям отправлять и получать текстовые сообщения, бронировать столики в ресторанах и использовать инструменты программирования для изменения кода на основе словесных описаний разработчиков.
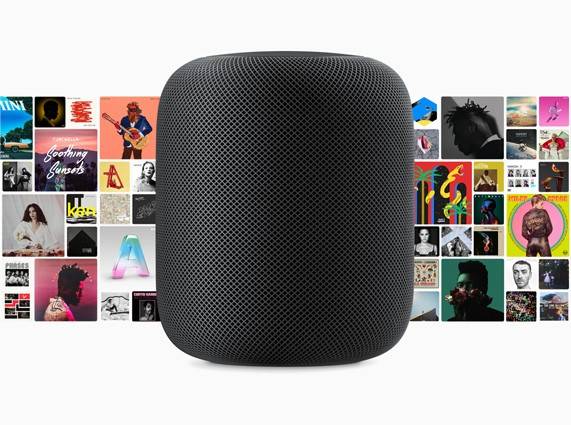
▲ Apple HomePod
Однако, несмотря на то, что голосовой ИИ способен справляться с задачами гораздо более сложными, чем «включить свет», экраны всегда будут занимать важное место в нашей жизни. Набор текста на клавиатуре и щелчок мышью не могут быть заменены голосовым управлением.
Это происходит не потому, что модель недостаточно интеллектуальна, а потому, что она ограничена физическими свойствами звука как среды передачи информации.
Звук обладает линейной структурой, что делает его особенно подходящим для передачи расплывчатых намерений в планировании задач с помощью ИИ. Примерами могут служить программные идеи и указания агентам по выполнению задач.
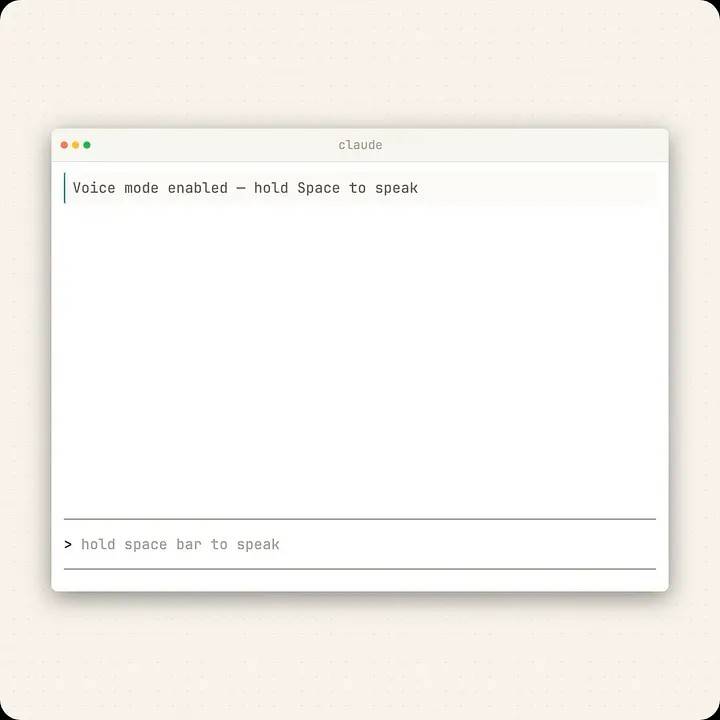
▲ Голосовой режим Claude Кода
Однако в рабочей или производственной среде это не идеально для одновременного просмотра нескольких вариантов. При написании статей нам необходимо с первого взгляда видеть структуру абзаца и иметь возможность вернуться назад и внести изменения в любой момент; при написании кода нам приходится постоянно смотреть на экран, чтобы сравнивать различия в коде с результатами выполнения.
Даже при простом бронировании авиабилета, отображение на экране цен, времени отправления и прибытия, а также правил возврата и изменения бронирования для нескольких рейсов одновременно гораздо эффективнее, чем зачитывание этих данных голосовым помощником по одному.
Чем больше полномочий у ИИ в выполнении задач за людей, тем больше людям необходим визуальный интерфейс для проверки выполненных действий, а также для остановки и возврата к предыдущим действиям до возникновения ошибок.
Физическая обстановка и правила поведения в обществе тонко определяют границы речи. За рулём, во время приготовления пищи или с ребёнком на руках, когда и глаза, и тело заняты, говорить, несомненно, является самым простым решением; однако, как только обстановка переносится в тихий офис открытой планировки, всё равно кажется слишком странным, чтобы один человек непрерывно говорил перед компьютером. Когда весь офис говорит одновременно, это напоминает большой колл-центр.
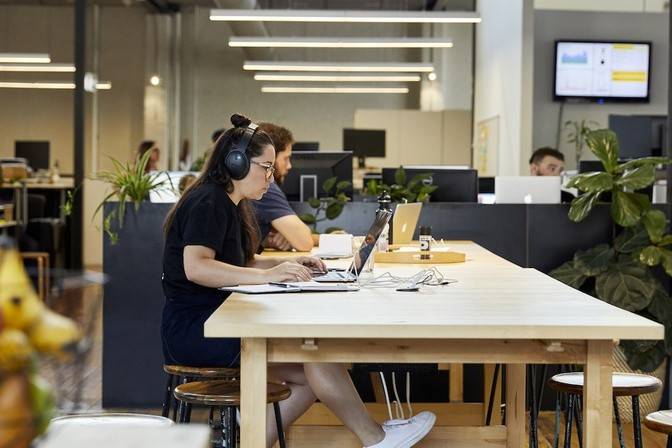
Эти сценарии связаны с ограничениями пропускной способности информации и границами конфиденциальности, которые инженеры не могут устранить, независимо от того, на сколько миллисекунд они сократят задержку модели.
Пророчество из научно-фантастических фильмов о том, что «скажи компьютеру слово, и все будет сделано», постепенно сбывается. Однако чем больше машин учатся говорить как люди, тем яснее мы понимаем, когда уместно говорить, а когда следует молчать.