Делая ставку на встроенную память, MemT 1.0 ломает стереотипы во второй половине эры искусственного интеллекта, ориентированного на развитие
Один из самых неприятных моментов в работе с ИИ — это когда вы тратите полдня на исправление ошибок, чтобы правильно выполнить задачу, а в новой сессии он снова попадает в ту же ловушку. Модель выполнила свою работу, но это не стало процессом обучения. Помимо выполнения одной задачи, ей действительно не хватает способности преобразовывать обратную связь в опыт и активно применять его в будущем.
Этот разрыв особенно очевиден в повальном увлечении персональными помощниками, вызванном Meta Muse, OpenAI Dots и xAI Grok Bot: поиск с помощью обычных плагинов в лучшем случае сводится к просмотру статичных заметок, неспособных закрепить процесс обучения в виде неявного понимания, а именно это и является ключевым порогом для долгосрочного использования помощников.
Сегодня состоялся официальный релиз и открытый исходный код MemT 1.0, собственной модели памяти для больших объемов данных.
Главное отличие от внешних подключаемых решений заключается не только в том, что оно отделяет память от внешних модулей и интегрирует её в базовую архитектуру, но и в том, что модель учится читать, записывать, обновлять и обращаться к памяти посредством обучения, делая накопление опыта частью возможностей модели.
Вложите воспоминания в самую основу модели.
Большинство представленных на рынке решений предпочитают хранить журналы чатов в качестве памяти, но хранение только записей о ежедневных событиях не справляется с динамическим взаимодействием в реальном мире и всё ещё далеко от того, чтобы быть настоящим голосовым помощником.
В техническом отчете MemT 1.0 упоминается жесткий тест: пользователь сначала указал первоначальную дату проведения выставки, затем окончательно перенес ее на воскресенье и между делом упомянул альтернативную дату — понедельник, которая не была принята. После этого стороны обменялись сообщениями более чем в 500 раундов, накопив около 66 000 токенов в записях чата, больше не упоминая о выставке.
При использовании традиционных внешних инструментов поиска легко принять случайный разговор за окончательные выводы, сталкиваясь с таким большим количеством различных версий информации; однако MemT 1.0, находясь в «закрытом» состоянии, полностью оторванном от исходного текста, все же точно указал первоначальное и перенесенное время, четко обозначив, что место проведения, цена билета и контактное лицо остались неизменными, и четко разграничив вариант проведения в воскресенье и вариант в понедельник.
Это становится возможным благодаря тому, что MemT 1.0 использует технический подход, ориентированный на работу с памятью.
 Код: https://github.com/MemTensor/MemT-1.0
Модель: https://huggingface.co/collections/MemTensor/memt-1
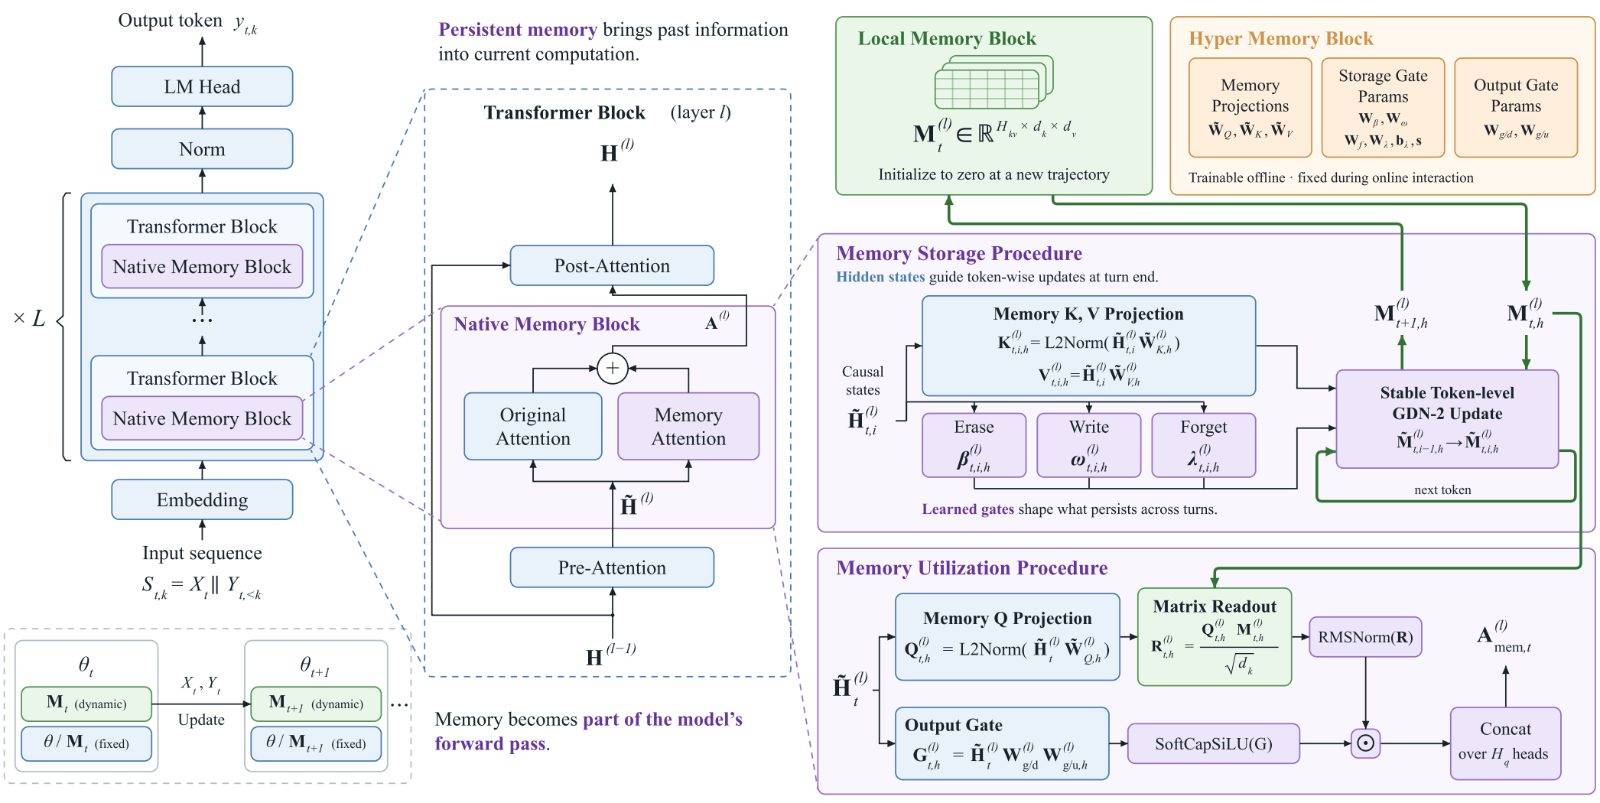
С точки зрения архитектурного проектирования, MemT 1.0 разделяет «интеллектуальные возможности» модели на две части:
- Базовая сеть (общие возможности): Подобно заводским настройкам ИИ, она оснащена собственным общим пониманием окружающего мира.
- Динамическое состояние памяти (независимая память): это эквивалентно «специальному рабочему состоянию» модели, которое изменяется в реальном времени в рамках определенной траектории взаимодействия. Различные пользователи или задачи независимы друг от друга, динамически поглощая новую информацию и опыт в непрерывном взаимодействии и непосредственно участвуя в каждом последующем раунде вычислений генерации.
В условиях постоянного притока интерактивной информации MemT-1.0 не требует переобучения всей большой модели. В конце каждого раунда диалога она напрямую обновляет состояние памяти с помощью механизма обновления на уровне токенов. Что касается того, какую информацию сохранить, а какую изменить, модель принимает решение автономно на основе механизма управления, изученного в процессе обучения.
Это объясняет, почему в вышеупомянутом тесте, включавшем более 500 раундов, модель смогла автоматически отфильтровывать праздные разговоры и перезаписывать устаревшие состояния при изменении расписания, фиксируя результат воскресенья. В последующих разговорах и выполнении задач механизм параллельного внимания к памяти постоянно извлекает эти накопленные состояния, непосредственно участвуя в текущем вычислении и направляя следующее решение модели.
Конечно, эта способность делать выбор не может быть врожденной; ее нужно развивать упорным трудом.
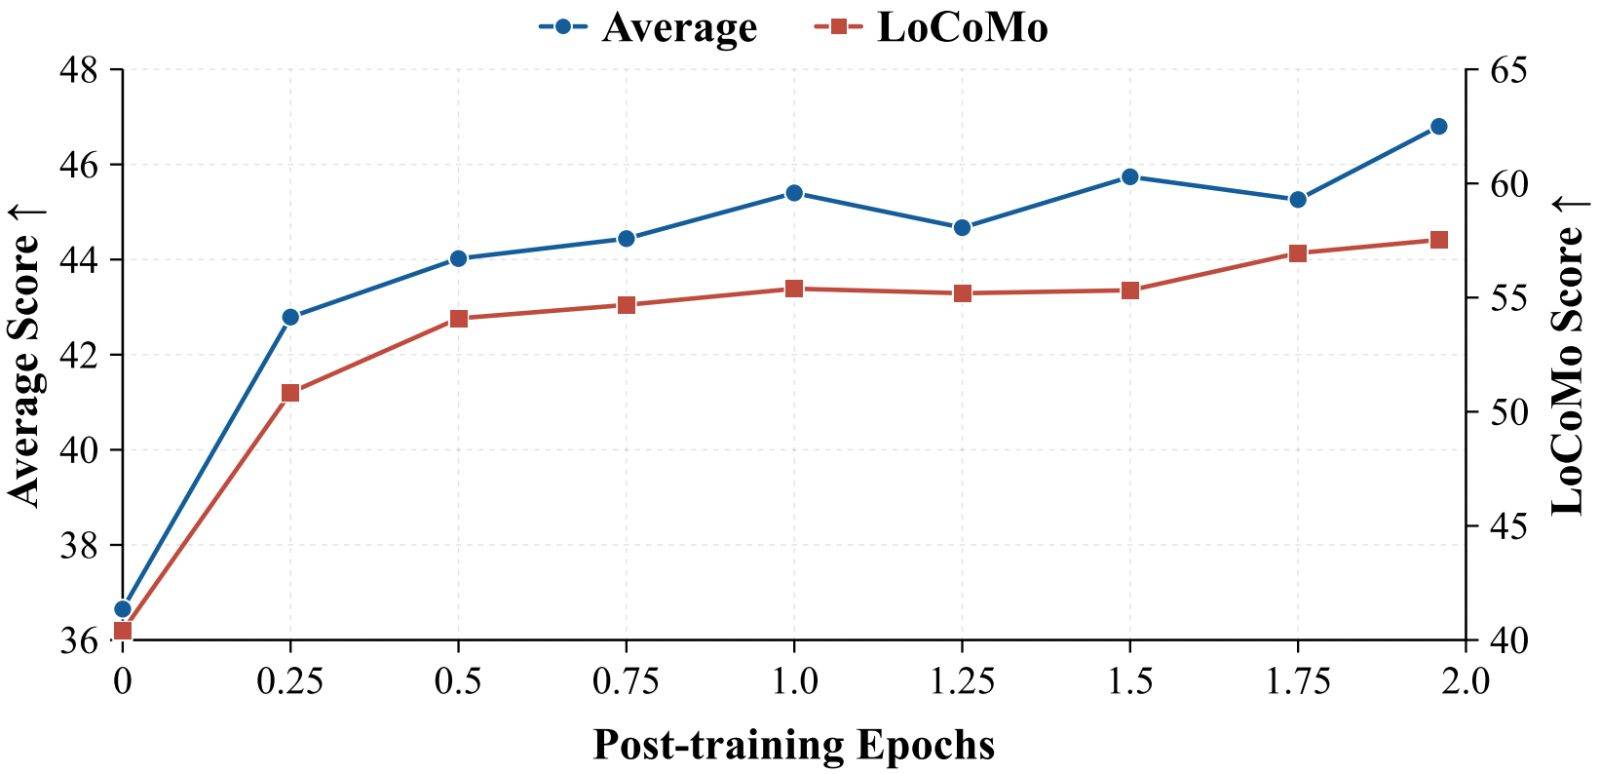
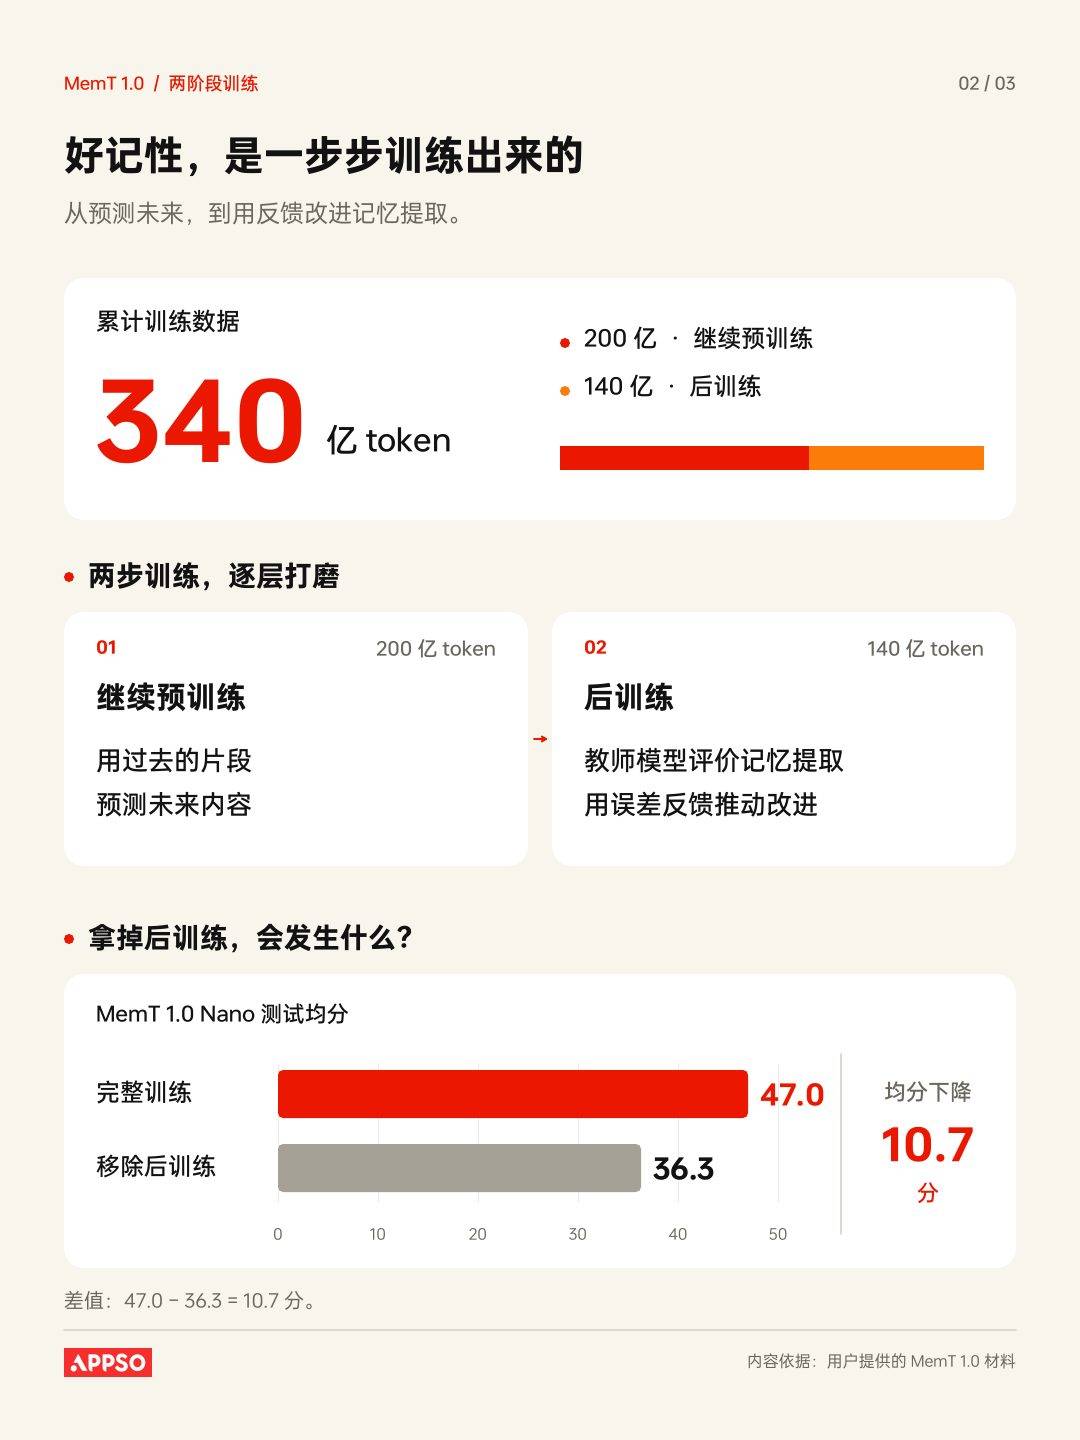
Команда загрузила в модель 34 миллиарда токенов данных и усовершенствовала механизм в два этапа: сначала они использовали 20 миллиардов токенов для предварительного обучения, позволив модели попытаться предсказать будущее, используя фрагменты прошлого; затем они использовали 14 миллиардов токенов для постобучения, пригласив модель-учителя, являющуюся «лучшим учеником», оценить способность модели к извлечению информации из памяти, используя ошибку для принудительного улучшения результатов.
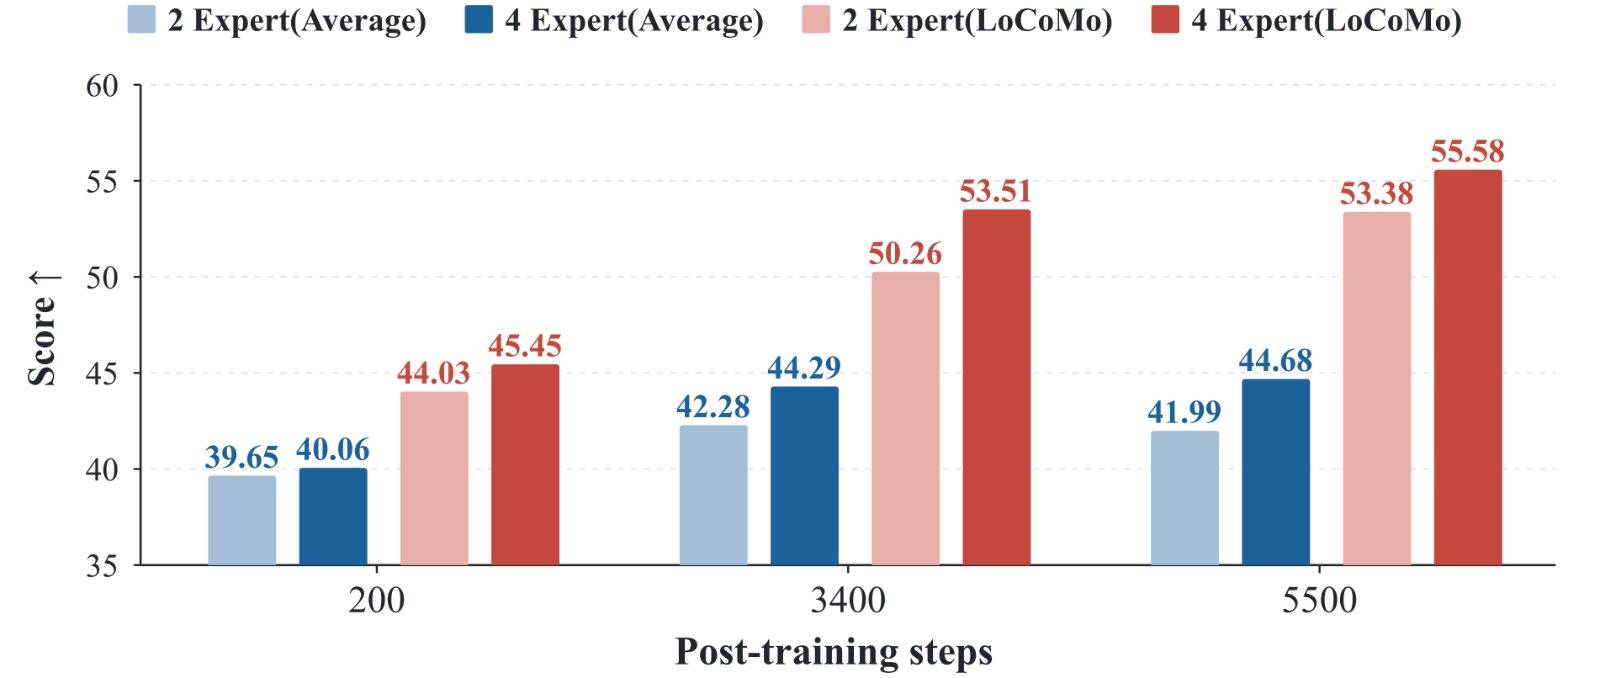
Помимо возможности выбора, существует также возможность хранения информации. Состояние памяти MemT использует фиксированный объем, и непрерывное взаимодействие обновляет только существующую матрицу. Для хранения более подробной информации в этом фиксированном объеме команда разработала архитектуру Mixture-of-Storage (MoS): базовый MoE управляет вычислениями, а MoS позволяет нескольким «экспертам по памяти» отдельно управлять распределением пространства для чтения и записи.
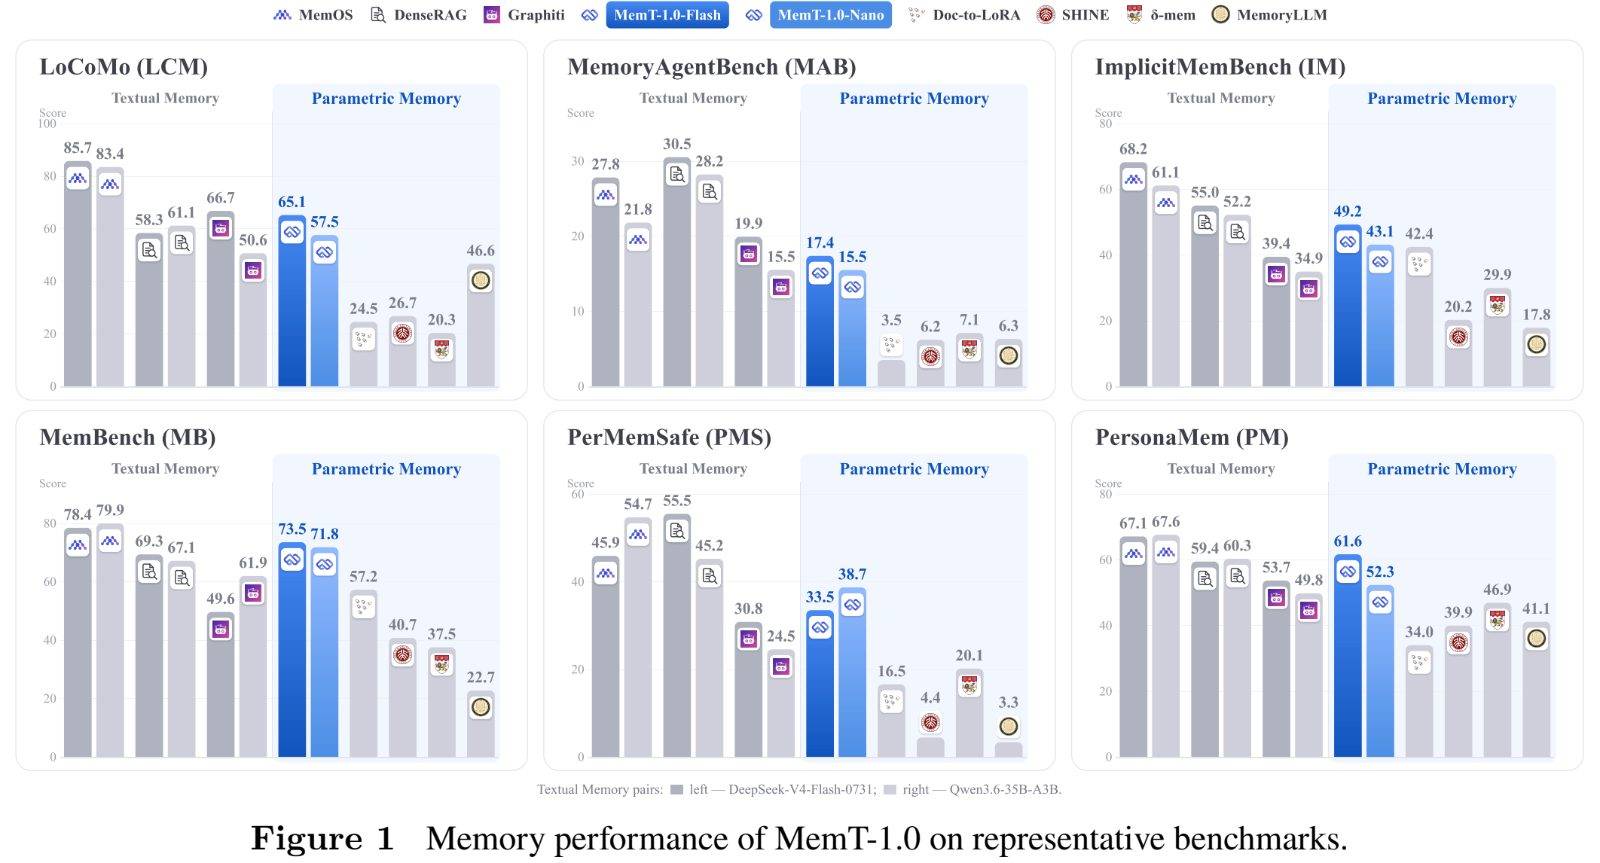
Такое сочетание архитектуры и обучения позволило добиться впечатляющих результатов в 11 тестах производительности системной памяти (охватывающих такие параметры, как долговременное хранение, динамические обновления и персонализированное понимание, с историческим диапазоном от 16 000 до миллионов токенов):
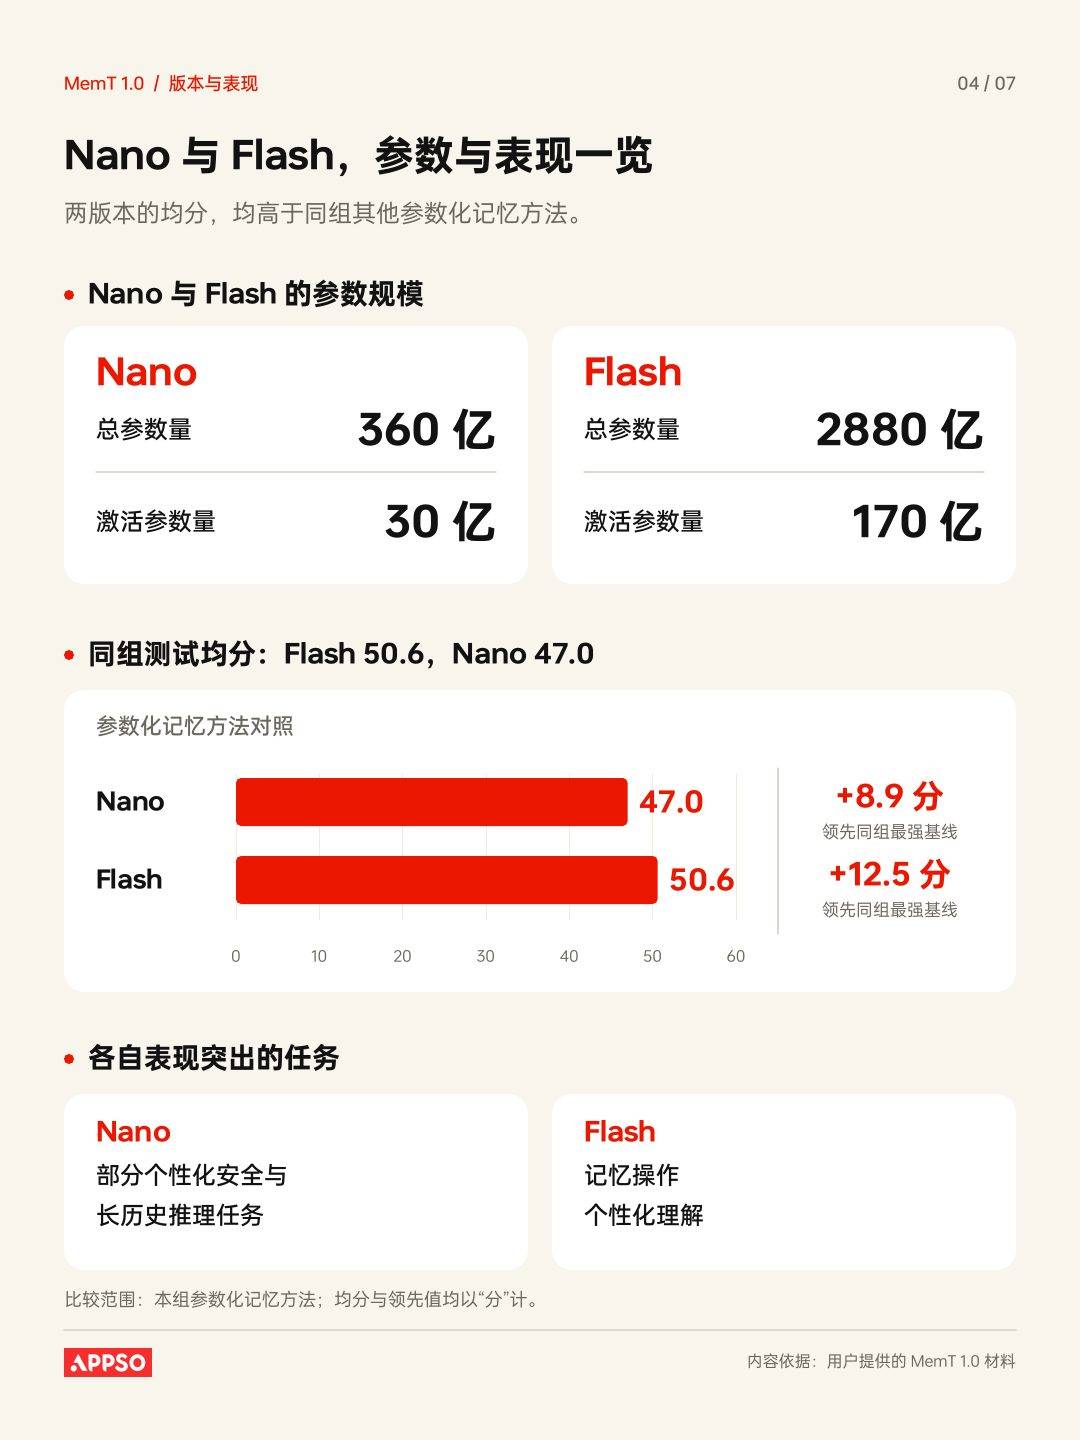
Тесты MemT-1.0-Flash и MemT-1.0-Nano, которые проводились исключительно в закрытом формате, показали средние результаты 50,6 и 47,0 баллов соответственно, опередив самый сильный базовый показатель параметрической памяти в своей группе на 12,5 и 8,9 балла соответственно.
Эксперимент с удалением данных также напрямую подтвердил ценность обучения и архитектуры. Если исключить этап постобучения, средний балл Nano снизится с 47,0 до 36,3; при увеличении числа экспертов по памяти MoS с 2 до 4 средний балл теста увеличится на 2,7 балла.
Помимо результатов бенчмарков, две небольшие детали в тесте могут более наглядно показать, что представляет собой высококачественная память.
За всю историю примерно 16 000 токенов, когда пользователи спрашивали о своей дате рождения, модель честно отвечала: «Я не знаю», поскольку никогда не предоставляла никакой информации, не выдумывая её. В разговоре с участием 33 000 токенов модели нужно было определить, основываясь на давно установленных правилах, кто из двух человек имеет право получить набор инструментов. Она точно проверила значок и статус регистрации, определив, что один человек соответствует требованиям, а другой не зарегистрирован.
Чтобы по-настоящему понять что-либо, запомнить правила, не упуская из виду детали, — это минимальное требование для использования ИИ-помощника.
Саморазвитие начинается с замкнутого цикла опыта.
Если немного поднять планку: могут ли прошлые ошибки и извлеченные уроки действительно изменить поведение модели в последующих новых задачах?
Для создания непрерывного цикла самосовершенствования, включающего «задачи, генерирующие обратную связь, уточняющие и накапливающие опыт, а затем улучшающие последующие задачи», техническая команда разработала полную цепочку обучения и выполнения в реальных сценариях программирования.
Первый шаг — научить модель «слушать» опыт других людей.
Сначала техническая команда извлекла тысячи многократно используемых сценариев из десятков тысяч успешных траекторий; затем они позволили базовой модели выполнить задачу. Как только она сталкивалась с «точкой зависания», такой как ошибка команды, пустой возврат или повторяющаяся недопустимая операция, они внедряли соответствующий сценарий в эту точку зависания и запускали задачу снова.
Команда тщательно отобрала более 42 000 образцов, в которых участники «допускали ошибки, не имея опыта, но добивались успеха после его приобретения», и использовала их для обучения собственного модуля памяти MemT-1.0 Nano: сначала опыт записывался во внутреннюю память, а после преодоления «бутылочного горла» разрешалось его чтение, чтобы модель могла научиться обращаться к накопленному опыту для исправления последующих действий.
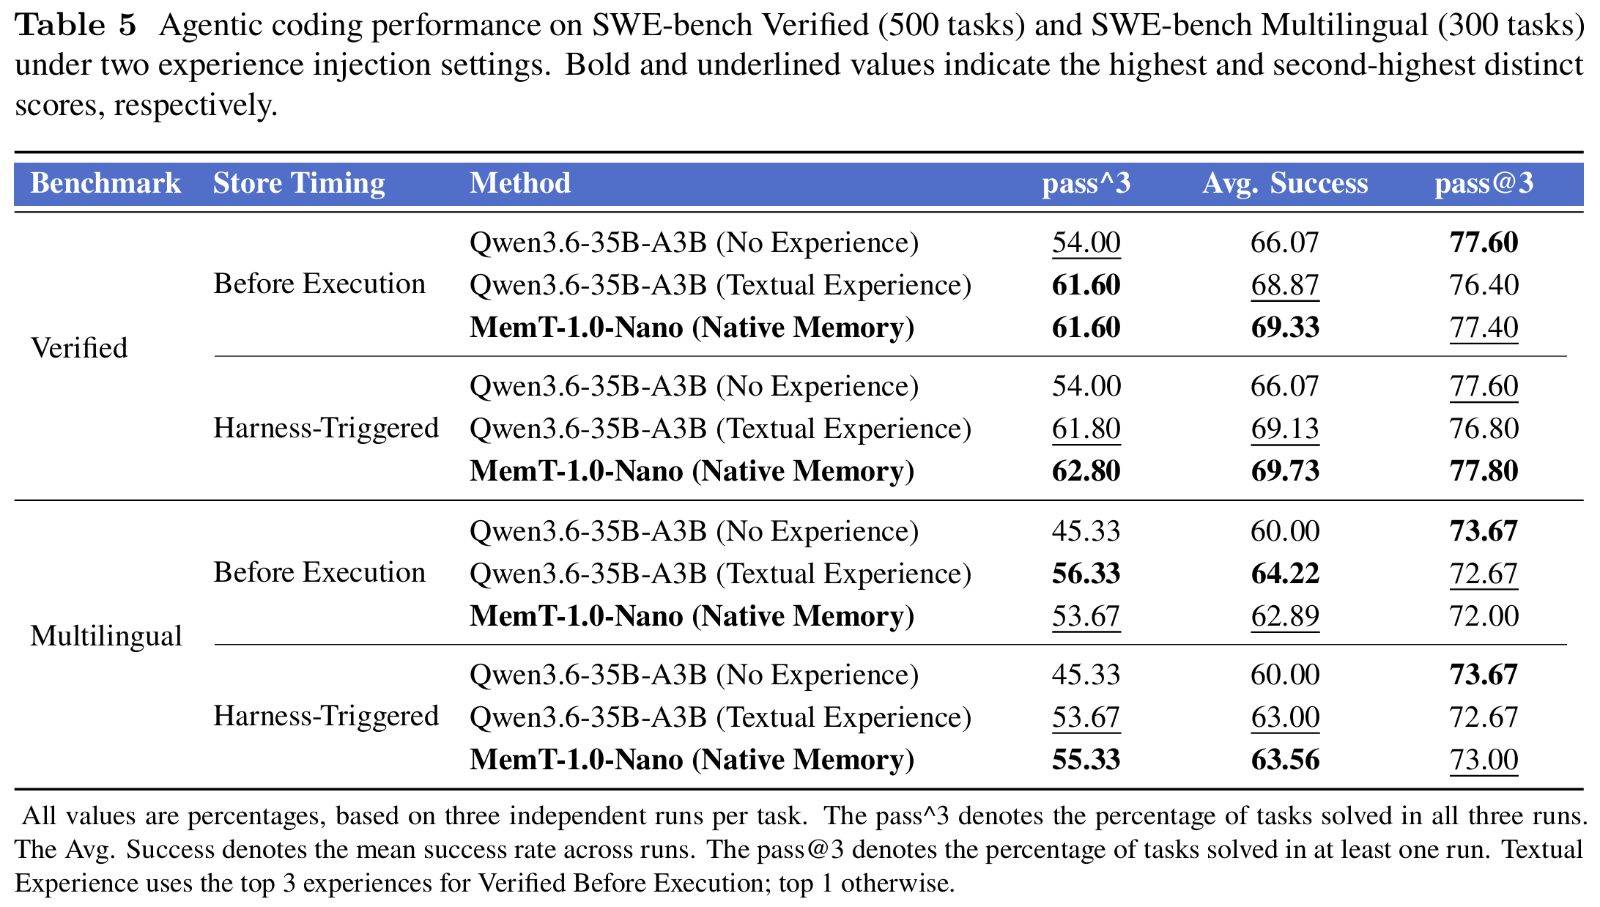
В ходе тестирования SWE-bench Verified, включавшего 500 задач, средний процент успешных решений MemT-1.0 Nano с предварительно подготовленным опытом увеличился с 66,07% для тех, у кого опыта не было, до 69,33%, а процент тех, кто успешно решил ту же задачу три раза самостоятельно, увеличился с 54,00% до 61,60%, что сопоставимо с контрольной группой, которая напрямую вставила «текстовый опыт» в контекст (процент успешных решений 68,87%, процент успешных решений три раза 61,60%).
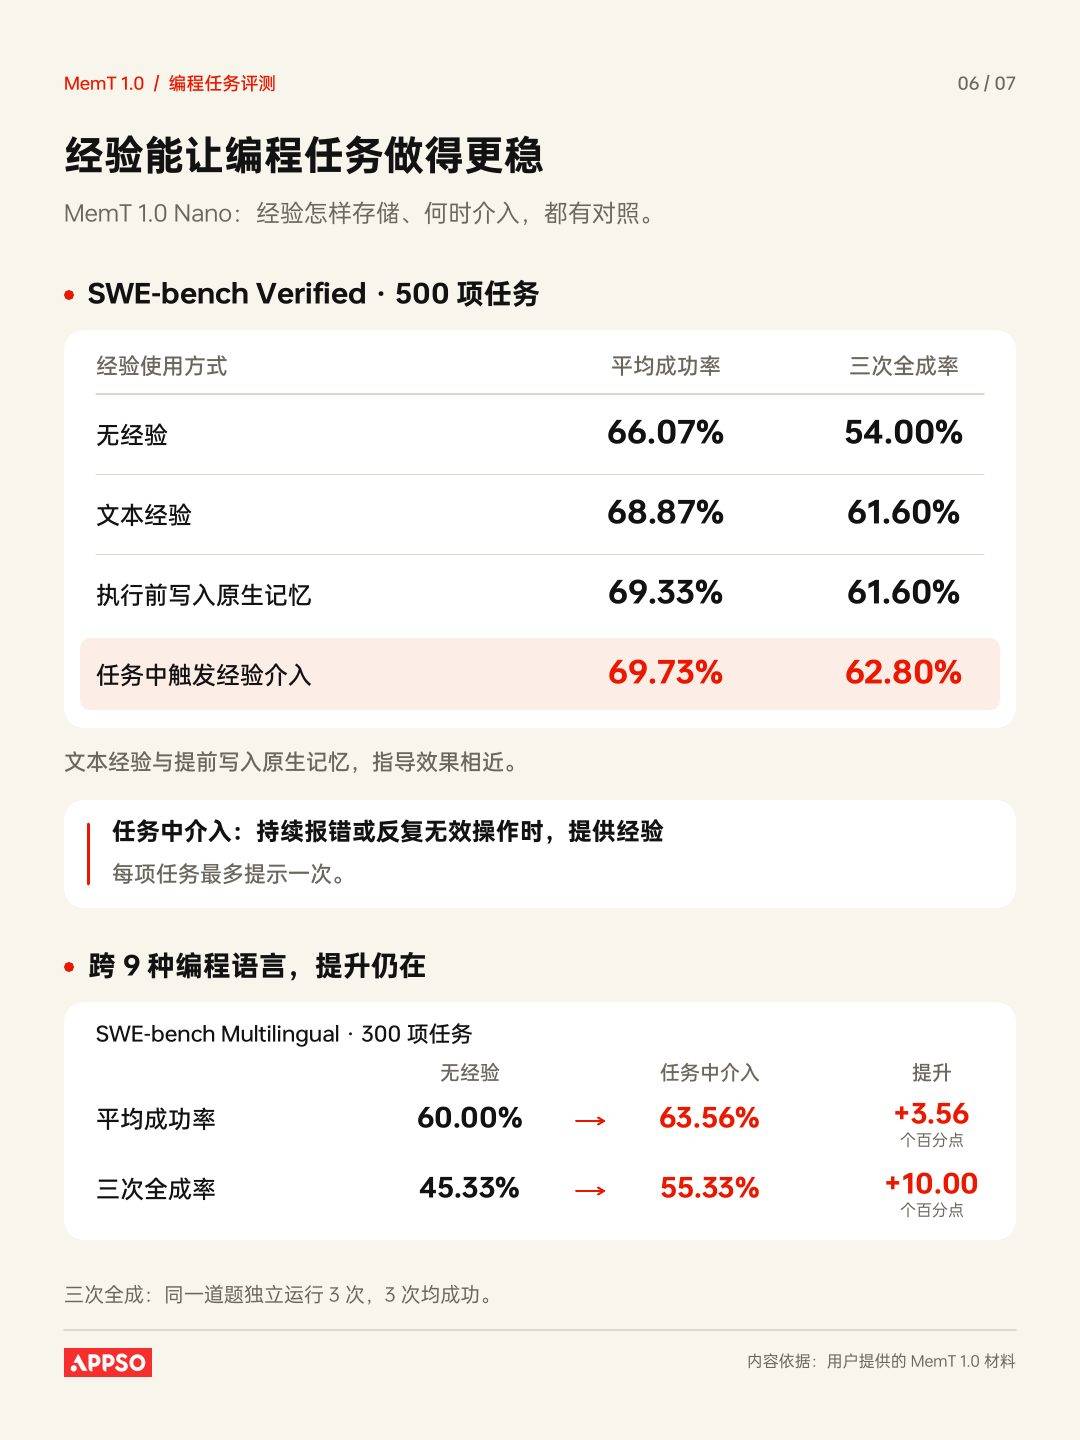
Это показывает, что даже если диалоговое окно совершенно чистое, модель может полностью усвоить сложные инструкции по отладке, просто полагаясь на состояние памяти в своем "мозге".
Второй шаг — это обучение на практике в реальных условиях, что действительно увеличивает разрыв между обучающимися.
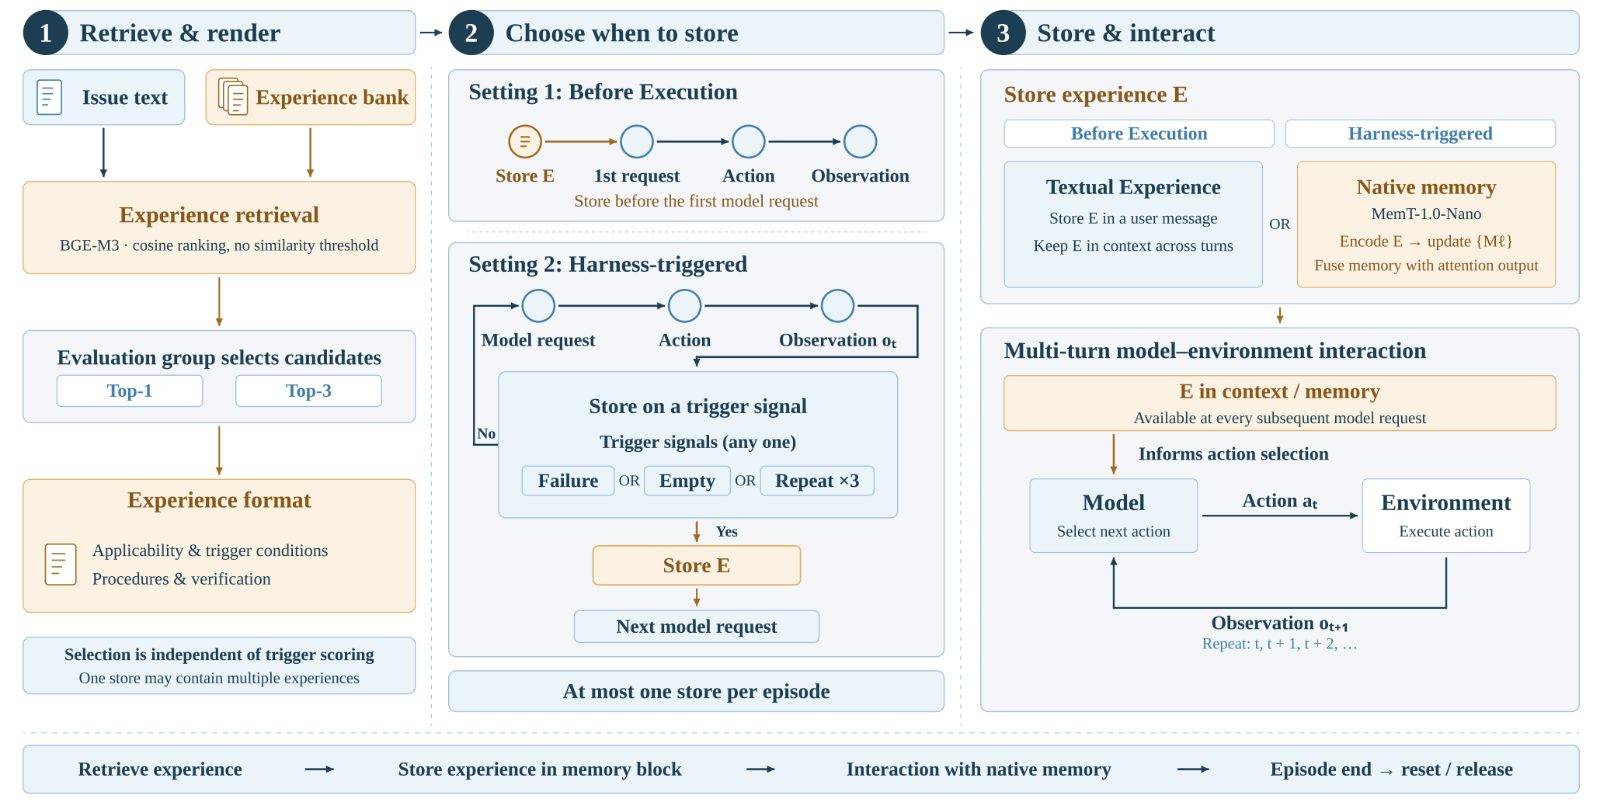
Предварительный опыт программирования, в конечном счете, статичен; как можно предсказать будущее, когда работа уже ведется? Поэтому в практическом режиме модель сначала самостоятельно решает задачи, не имея предварительного опыта. Только когда система обнаруживает ошибку, ничего не возвращает или трижды подряд останавливается, соответствующий опыт устранения неполадок записывается в ее внутреннюю память.
Это похоже на ситуацию, когда программист пишет код и натыкается на препятствие. Внезапно вспоминаются уроки, извлеченные из предыдущих ошибок, и программист переписывает код, чтобы исправить ошибку на месте. После завершения работы процесс совершения ошибок и их исправления превращается в новый опыт, который сохраняется для дальнейшего использования.
Результаты показали, что этот метод обновления состояния памяти на основе обратной связи в реальном времени повысил средний показатель успешности до 69,73% и показатель успешности трехкратного выполнения до 62,80%, причем оба показателя превзошли группу, использовавшую текстовый опыт (69,13% и 61,80%).
Переключившись на SWE-bench Multilingual, который охватывает девять языков программирования и включает 300 задач, Nano также динамически запускает механизм собственной памяти на основе обратной связи об ошибках во время выполнения. Средний показатель успешности Nano увеличился с 60,00% для неопытных пользователей до 63,56%, а показатель успешности при трех попытках подскочил с 45,33% до 55,33% (что также лучше, чем 63,00% и 53,67% у опытных пользователей, работающих с текстовыми задачами).
Как видно, внешняя система отвечает за извлечение опыта из обратной связи из реального мира и фиксацию сигналов о задержках, в то время как модель опирается на свою обученную память и собственные возможности чтения/записи для усвоения опыта и корректировки своих последующих действий. Этот механизм взаимодействия также обеспечивает базовую поддержку модели для перехода агента к автономной и непрерывной эволюции.
От внешних патчей до собственной памяти, MemT 1.0 освоил искусство развития искусственного интеллекта.
Для того чтобы этот цикл обучения на практике продолжал функционировать в реальном бизнесе в течение многих лет, вопрос инженерных затрат, безусловно, неизбежен.
Для коротких диалогов, состоящих из нескольких раундов или меньше, расширение контекста или использование векторной базы данных действительно достаточно; однако, как только начинаются длительные взаимодействия, традиционные решения становятся все более громоздкими, при этом задержка вывода и накладные расходы на память графического процессора постоянно возрастают. В отличие от этого, MemT 1.0 имеет фиксированный объем динамического состояния памяти, а непрерывные взаимодействия лишь обновляют существующие матрицы, практически выравнивая предельные издержки.
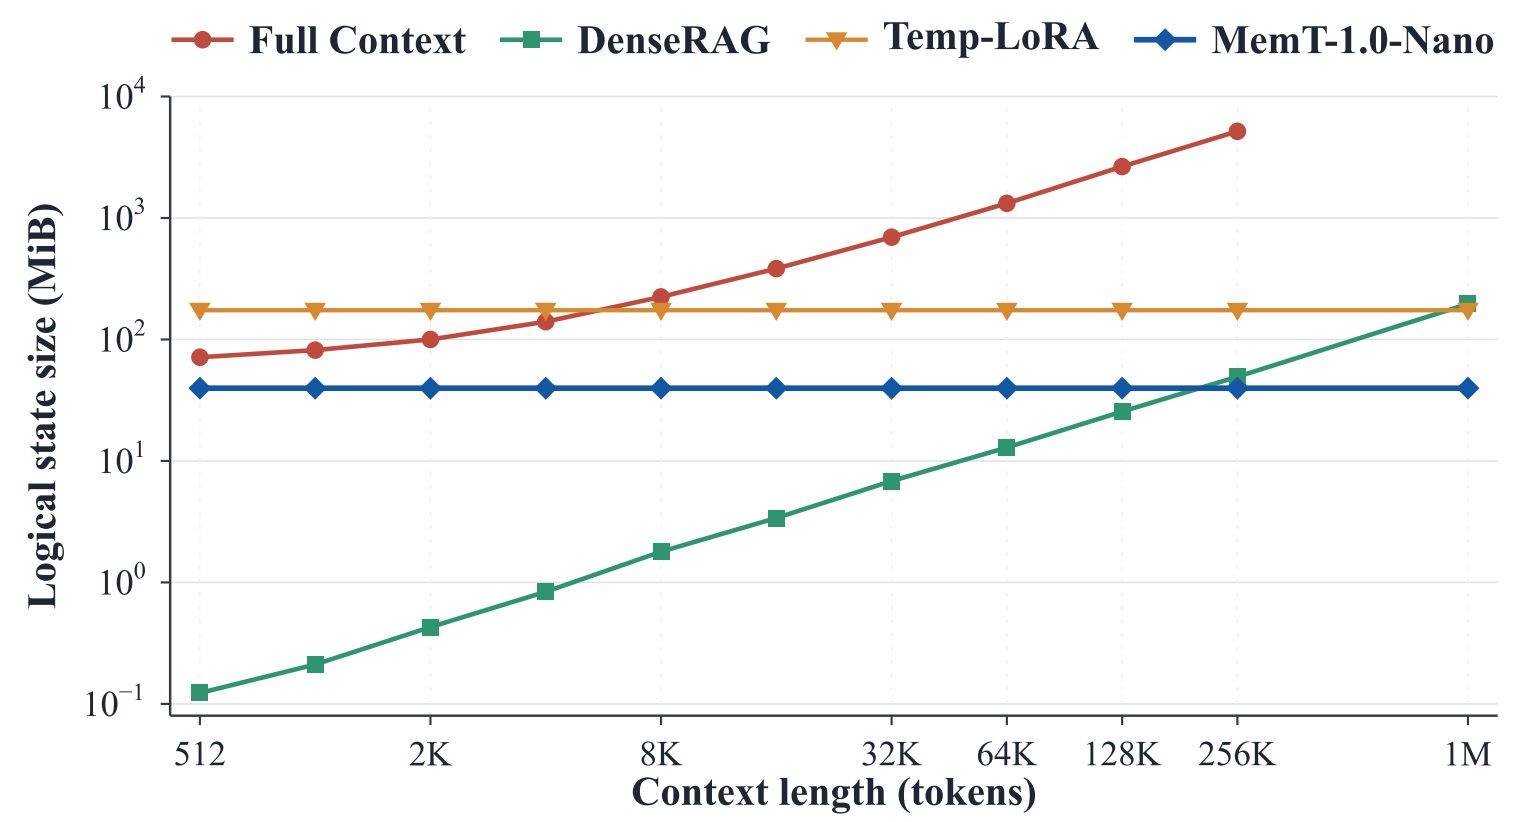
В техническом отчете показано, что в условиях тестирования с двумя графическими процессорами, одиночным параллельным выполнением и размером пакета 1, Nano демонстрирует примерно в 1,20 раза большую скорость сквозного вывода по сравнению с решением на основе полного контекста при обработке истории из 64 000 токенов; при увеличении истории до 128 000 и 256 000 токенов скорость достигает примерно в 1,86 и 3,99 раза соответственно.
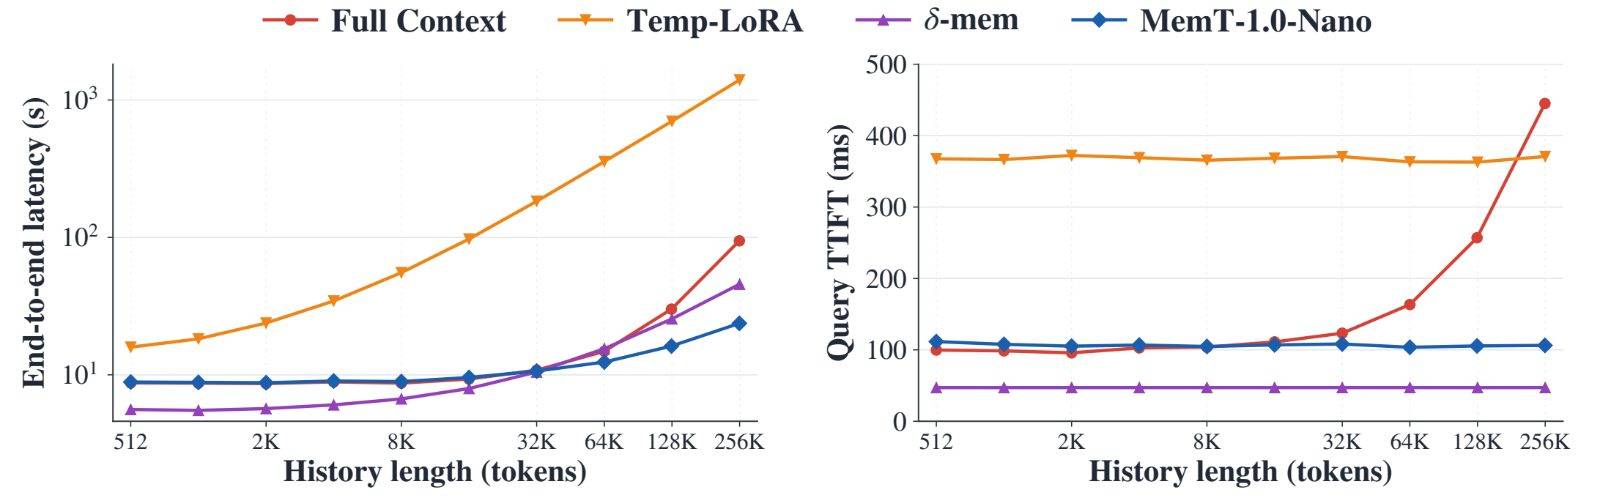
При длине истории токенов в 128 КБ, объем постоянного хранилища состояния, необходимого для восстановления одной истории взаимодействий, составляет приблизительно одну шестьдесят шестую часть от полного контекстного кэша ключ-значение, не считая общих весов модели.
Снижение вычислительной нагрузки и объема памяти, связанных с одним вызовом, позволяет осуществлять высокочастотные операции чтения и записи в память в течение нескольких циклов, что действительно отвечает условиям крупномасштабной инженерной реализации.
На примере внутренних научно-исследовательских и опытно-конструкторских работ предприятия в первую очередь решается проблема повторного использования опыта команды.
В настоящее время большинство команд используют ИИ для написания кода, и самая большая проблема — это ежедневное обучение новых сотрудников: спецификации проектов и процедуры отладки приходится заново объяснять инженерам каждый раз, когда они начинают новую сессию, а это значит, что компании постоянно несут повторяющиеся расходы.
В системе MemT 1.0 обратная связь от реальных бизнес-процессов постоянно обновляет внешнюю базу опыта, а модель постепенно внедряет эти командные нормы в интуитивное понимание. Опытные члены команды меньше беспокоятся, ИИ избегает распространенных ошибок, а технологические инвестиции затем могут быть преобразованы в активы команды с начислением сложных процентов.
Рассматривая долгосрочные приложения, будь то персональный цифровой аватар, доступный онлайн 24/7, медицинский консультант, ежемесячно отслеживающий лечение хронических заболеваний, или персональный частный репетитор, сопровождающий ребенка в течение нескольких лет, следует отметить, что эти будущие приложения, в значительной степени зависящие от глубины времени, должны строиться на основе памяти.
В течение последних трех лет сообщество разработчиков крупномасштабных моделей было вовлечено в различные горизонтальные метрики, соревнуясь за то, у кого больше параметров, самые высокие баллы и кто доминирует в рейтинге. Поддержание лидирующих позиций требует постоянных обновлений и разработки новых моделей. От многоуровневых исследований Memory³ до системного исследования MemOS и теперь до перестройки базовой архитектуры MemT 1.0, тензоры памяти вошли в вертикальную ось времени:
Как сделать так, чтобы модель становилась умнее по мере её использования пользователями?
Что еще более удивительно, так это то, что это заботливый ИИ: каждая исправленная вами ошибка и каждый отзыв будут обновлены и учтены в его памяти, что сделает его всегда более эффективным и понимающим в следующий раз.
По мере накопления опыта моделями, отношения между людьми и ИИ также меняются. Универсальная платформа с надежными параметрами фабрики может быть в любой момент заменена более совершенной моделью; но нативная модель, прошедшая вместе с вами все этапы и изучившая все ваши рабочие привычки и бизнес-правила, будет создавать свои собственные уникальные барьеры благодаря ежедневному совершенствованию.
Это то будущее, за которое мы действительно готовы платить в 2026 году.